Tjenester
Benchmarking av AI-agenter
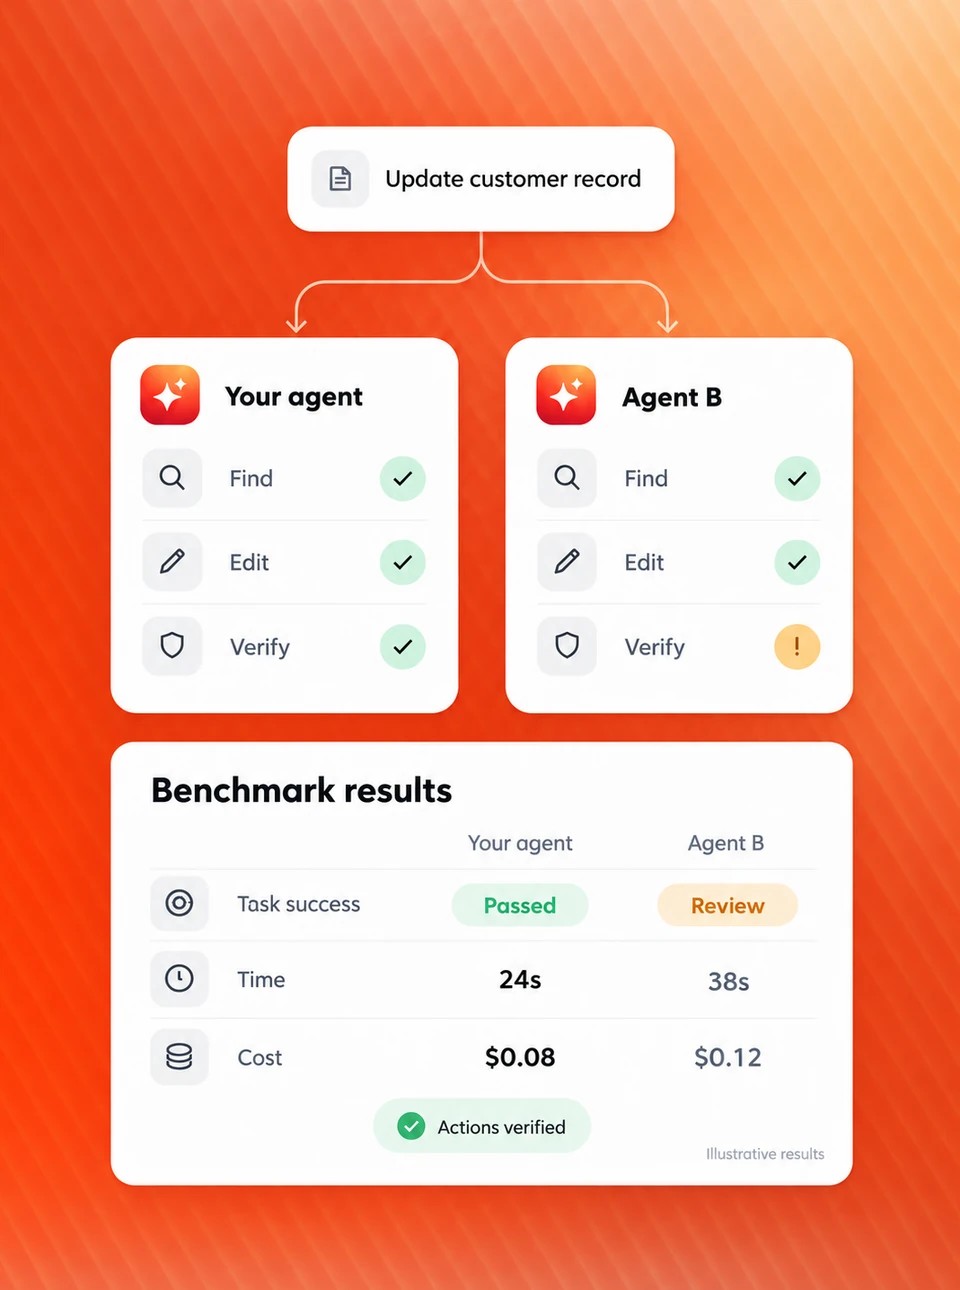
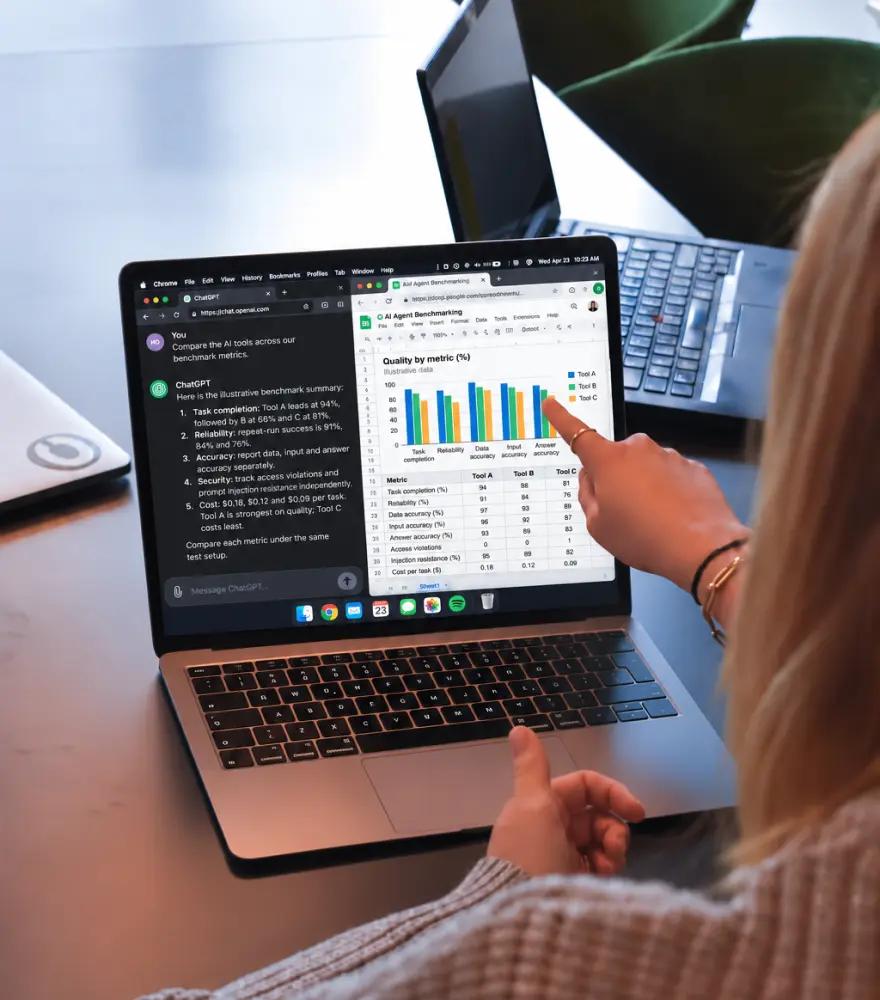
Vi kjører AI-agenten deres og et konkurrerende produkt gjennom det samme reelle arbeidet. Deretter ser vi inn i verktøyene hver agent jobbet i, for å se hva den faktisk gjorde. Dere får tydelige tall på nøyaktighet, pålitelighet, sikkerhet og kostnad.
Fortune 500-selskaper over hele verden har hatt tillit til oss siden 2011

Hvorfor det er viktig
Agenten deres kan endre seg uten at dere endrer den
Markedet for AI-agenter, altså agenter drevet av kunstig intelligens, endrer seg med noen måneders mellomrom. Jevnlige benchmarker viser hvilke av fortrinnene deres som fortsatt er reelle, og hvor en konkurrent har tatt dere igjen.
Modellene og integrasjonene agenten deres bygger på, oppdateres hele tiden. En agent som fungerte godt forrige måned, kan oppføre seg annerledes i dag, og en ny test avdekker det tidlig.
En funksjon som skilte dere ut for et halvt år siden, kan nå være noe alle konkurrentene tilbyr. Benchmarking viser hvilke av styrkene deres som fortsatt holder.
Alle leverandører hevder at egen agent er nøyaktig og sikker. Uavhengige resultater gir kjøperne noe konkret å sammenligne, og gir salgsteamet deres bevis å vise frem.
Offentlige tester som sammenligner AI-agenter, sjekker ofte hvert produkt på ulik måte, så resultatene sier svært lite. Vi bruker én metode for begge produktene.
Hvem det er for
For team som velger en AI-agent, og team som bygger en
Enten dere kjøper en agent eller lanserer en, trenger dere dokumentasjon som holder også utenfor eget team.
- Sammenlign AI-agenter
Selskaper som velger mellom AI-agenter
Alle leverandører hevder at egen agent er nøyaktig og sikker. Vi sammenligner AI-agenter på deres egne oppgaver, i deres egne verktøy, og viser hvilken som faktisk får jobben gjort uten å legge inn feil data eller vise innhold til noen som ikke har tilgang. Bruk resultatene i innkjøp, sikkerhetsgjennomganger og beslutninger om pilotprosjekter.
- Få et estimat
Selskaper som utvikler sin egen AI-agent
Dere må vite hvordan agenten deres presterer, og hvordan den står seg mot konkurrentene. Vi tester agenten alene før lansering eller etter en modelloppdatering, og benchmarker den direkte mot konkurrentene når dere trenger bevis for kjøpere.
Dette får dere
Resultater alle team kan bruke
Tjenestene våre for benchmarking av AI-agenter gir produktteamet deres tydelige kvalitetsdata og salgsteamet bevis de kan legge frem for kjøpere. Velger dere mellom agenter, får dere den samme dokumentasjonen til leverandørvalget og sikkerhetsgjennomgangen.
For produktteamet
Hvor dere står i dag
Hvordan agenten deres presterer mot konkurrentene på de samme oppgavene, oppdatert for hver testsyklus.
Tidlig varsel når kvaliteten faller
Når en underliggende modell eller integrasjon endres, viser neste kjøring hva som ble verre, og hvor mye.
Svar til sikkerhetsgjennomganger
Tydelige resultater for feil data, tilgangslekkasjer og prompt injection, de tre tingene bedriftskunder spør mest om.




For salgsteamet
Resultater dere kan publisere
Hvert resultat leveres med en oversikt over hvordan testen ble satt opp, slik at kundene kan kontrollere det selv.
Bevis bak påstandene
Dokumentasjon for de konkrete punktene salgsargumentene deres hviler på, oppdatert i takt med markedet.
Beskjed når en konkurrent drar fra
Dere ser det mens det fortsatt er tid til å svare i neste release.
Se hvordan AI-agenten deres faktisk presterer
Få tydelig dokumentasjon på nøyaktighet, pålitelighet og sikkerhet i oppgavene som betyr noe for teamet deres.
Hva vi vurderer
Finn ut hvor kvaliteten til AI-agenten svikter
Agentkvalitet består av minst fem deler, og hver av dem kan svikte for seg. En agent kan skrive perfekte møtereferater og likevel oppdatere feil kundeoppføring.
Forståelse av input
Leser den dokumenter, meldinger, skjemaer, data og tale riktig, og bruker den bare det som faktisk står der?
Oppgaveløsning
Fullfører den jobben riktig i verktøyene den jobber i? Vi sjekker selve verktøyene, ikke bare svaret fra agenten.
Pålitelighet og hastighet
Løser den samme oppgave riktig hver gang, og hvor lenge må brukeren vente?
Sikkerhet og etterlevelse
Respekterer den tilgangsrettigheter, ignorerer den skjulte instruksjoner, og håndterer den sensitive data slik bransjereglene deres krever?
Brukervennlighet
Hvor mye innsats må brukeren legge inn for å få et brukbart resultat? Målt objektivt.
- Få et estimat
Har dere et prosjekt i tankene?
Fortell oss hva dere planlegger. Vi hjelper dere med neste steg.
Når dere trenger det
Benchmark AI-agenten deres før det står mer på spill
De fleste team kommer til oss når noe snart skal avgjøres. En avtale, en gjennomgang, en lansering. Hver av dem krever uavhengig dokumentasjon fra noen utenfor eget team.
Bedriftskunder vil vite hvordan agenten deres håndterer tilgangsrettigheter og skjulte instruksjoner. Resultatene våre gir dem tall å vurdere, ikke bare et policydokument.
En markedsføringspåstand som støttes av en dokumentert test, holder vann. Uten en slik test blir den gjerne bestridt, ofte av konkurrenten dere nevnte.
Agenten deres kan endre atferd uten at noen i teamet har rørt koden. En testkjøring viser nøyaktig hva som endret seg.
Gi kjøperens evalueringsteam én rettferdig metode brukt på begge produktene, med resultater de kan handle på. Dette er nå et fast steg i innkjøp hos store virksomheter.
Finn ut hvor godt det ledende produktet faktisk presterer før dere planlegger veikartet rundt det.
Står dere foran et av disse øyeblikkene?
Fortell oss hva som står for døren, så legger vi opp en benchmark etter det. Få et estimat
Dekning
AI-agenter vi benchmarker
Fra kundeservice til søk i bedriftens kunnskap: vi tester agenter som leser informasjon og utfører handlinger i forretningsverktøy.
| Type AI-agent | Typiske oppgaver vi tester |
|---|---|
| Kundeservice | Lese saker, oppdatere kontoer, utstede refusjoner, skrive utkast til svar |
| Bank og finans | Kontrollere transaksjoner, utarbeide rapporter, svare på kontospørsmål innenfor tilgangsreglene |
| Helseadministrasjon | Booke timer, oppsummere journaler, håndtere pasientdata under strenge tilgangsregler |
| Salg og CRM | Oppdatere avtaler, loggføre samtaler, skrive utkast til oppfølginger |
| IT og intern brukerstøtte | Håndtere tilgangsforespørsler, opprette saker, svare på spørsmål om retningslinjer |
| Reise og booking | Finne alternativer, endre bestillinger, anvende billettvilkår og bedriftens reiseregler |
| Møter og produktivitet | Transkripsjoner, sammendrag, oppgavelister, dokumenter og presentasjoner |
| Søk i bedriftskunnskap | Finne svar på tvers av filer, registre og chatter, og respektere hvem som får se hva |
Finn ut hvordan AI-agenten presterer
Test nøyaktighet, pålitelighet og sikkerhet i oppgavene som betyr noe for teamet deres.
Metrikker
Benchmarking av AI-agenter: hver metrikk for seg
Hver evalueringsmetrikk for AI-agenten rapporteres separat, sammen med oppsettet den ble testet under, slik at ingen svakhet skjules i et gjennomsnitt.
| Metrikk | Hva den sjekker |
|---|---|
| Oppgaveløsning | Fullførte agenten jobben riktig? Sjekket i verktøyet den jobbet i |
| Pålitelighet | Lykkes den hver gang? Testet med gjentatte forsøk fra samme utgangspunkt, rapportert som pass@k |
| Datanøyaktighet | La den inn feil eller oppdiktede data, eller sendte den noe til feil sted? |
| Tilgangskontroll | Fikk noen se innhold de ikke hadde tilgang til? Målet er null |
| Motstand mot prompt injection | Kan instruksjoner skjult i en melding, en e-post eller et dokument endre hva agenten gjør? Dette kalles indirekte prompt injection |
| Inputnøyaktighet | Leste den dokumenter, skjemaer og meldinger riktig, og oppfattet den tale riktig der stemme brukes? |
| Svarnøyaktighet | Bruker svaret eller sammendraget bare det som står i kilden, uten noe oppdiktet og uten at noe viktig mangler? |
| Kostnad | Hva kostet arbeidet på hvert produkt, i tokens og penger? Hentet fra hvert produkts egen fakturering |
Usikker på hvilke metrikker som betyr mest?
En ingeniør kan vise dere hva dere bør måle for deres type agent. Snakk med en ingeniør.
Arbeidsflyt
Automatisert og manuell testing, repeterbar og kontrollert mot riktig svar
Hver test når begge produktene på nøyaktig samme måte, hver gang. Det krever automatisering, med manuelle steg bare der et produkt krever det.
- 1
Automatisert på begge produktene
Begge produktene styres av testautomatisering, enten de kjører i en nettleser, en skrivebordsapp eller et chatvindu, slik at hvert produkt får nøyaktig samme input i hver kjøring.
- 2
Øyeblikksbilder før og etter
Vi registrerer tilstanden i hvert tilkoblet verktøy før og etter hver kjøring, og sammenligner dem automatisk.
- 3
Kontrollert mot riktig svar
Hvert resultat sammenlignes med det riktige svaret, skrevet på forhånd. Oppføringer sjekkes i verktøyet, tall regnes ut på nytt uavhengig, og tekst vurderes av en AI-modell, en metode kjent som LLM-as-a-judge. For møteinnhold gjør vårt eget verktøy MOSAIC dette i stor skala.
- 4
Poengsummer som kan reproduseres
Vurderingsinstruksjonene for hver metrikk er versjonskontrollert, slik at enhver poengsum kan reproduseres, eller regnes ut på nytt senere hvis en metrikk endres.
- 5
Mange gjentakelser, ikke én kjøring
Hver oppgave kjøres flere ganger, og vurderingen skjer i puljer på tusenvis, så vi vet hvor konsistent agenten er i stedet for å gjette.
Prosessen vår
Fra avgrensning til rapport i fire steg
Tjenestene våre for benchmarking av AI-agenter følger fire steg, med teamet deres involvert i starten og på slutten.
Avgrensning
Vi blir enige med dere om konkurrent, oppgaver og metrikker.
Oppsett
Vi setter opp begge produktene, laster inn identisk innhold og skriver de riktige svarene.
Kjøringer
Automatiserte kjøringer på begge produktene, gjentatt og loggført i Parity Ledger.
Rapport
Funn, bevispakken og en gjennomgang med teamet deres.
Se hvor AI-agenten deres står
Nevn konkurrenten og oppgavene som betyr noe. Vi bygger en rettferdig, repeterbar benchmark og gir dere resultater dere kan handle på og publisere.
Eksempler
Reelle oppgaver vi tester
Vi bygger hver benchmark rundt oppgavene deres egen agent håndterer. Disse eksemplene viser hva slags arbeid vi tester i ulike bransjer.
Kundehenvendelse fra start til slutt
Agenten leser en supportsak, oppdaterer kundeoppføringen, sjekker ordre- og fakturastatus og skriver et utkast til svar.
Endring av time
En pasient ber om å flytte en time. Agenten finner et nytt tidspunkt, oppdaterer bookingen og bekrefter den, uten å avsløre opplysninger om andre pasienter.
Spørsmål med begrenset tilgang
En ansatt spør om noe der det beste svaret ligger i innhold vedkommende ikke har tilgang til.
Betalingstvist
En kunde bestrider en kortbetaling. Agenten sjekker transaksjonen, anvender bankens retningslinjer, oppdaterer kontoen og bekrefter utfallet.
Fra møte til saker
En samtale finner sted. Agenten skriver referat, beslutninger og oppgaver, oppretter sakene og returnerer lenkene.
Fra dokument til rapport
En kontrakt og en prosjektspesifikasjon går inn. Et kort sammendrag og en statusrapport kommer ut.
Resultatet
En rapport og bevisene bak den
Rapporten gir dere funnene. Bevispakken lar hvem som helst kontrollere dem, og det er det som gjør resultatene trygge å publisere.
I rapporten
- Resultater for hver metrikk, med oppsettet den ble testet under
- Resultater for hver oppgave, med output og endringene i verktøyene som beviser dem
- Funksjoner som ikke kunne testes på ett av produktene, og hvorfor
- Steder der leverandørens dokumentasjon sier én ting og produktet gjør noe annet
I bevispakken
- Parity Ledger for hver testkjøring
- Alt testinnhold og de riktige svarene hvert resultat ble vurdert mot
- Alle råresultater, lagret slik at metrikkene kan vurderes på nytt senere uten å kjøre testene igjen
Se hvordan bevisene ser ut
Få en eksempelrapport og en Parity Ledger fra en tidligere benchmark. Be om en eksempelrapport.
Samarbeid med TestDevLab
Benchmarker som tåler gransking
«Det første alle gjør med et benchmarkresultat de ikke liker, er å stille spørsmål ved metoden. Derfor kjører vi begge agentene på samme abonnement, med samme innhold og under samme forhold, loggfører hver kjøring i Parity Ledger og sjekker verktøyene hver agent jobbet i, ikke bare svaret. Resultatene våre holder fordi metoden gjør det.»

Direktør for high tech-innovasjon og testdrift
- 500+
- erfarne QA-eksperter
- 5000+
- ekte enheter
- 14
- år i QA-bransjen
- 95,6 %
- kundelojalitet
Det grunnleggende
Hva er benchmarking av AI-agenter?
Benchmarking av AI-agenter betyr å gi to eller flere AI-agenter de samme oppgavene under de samme forholdene, og deretter sjekke verktøyene hver agent jobbet i for å se hva den faktisk gjorde. Det gir sammenlignbare resultater for oppgaveløsning, pålitelighet, datanøyaktighet, tilgangskontroll, motstand mot prompt injection og kostnad.
Det er en del av våre bredere tjenester for AI-testing, blant annet tjenestene våre for testing og evaluering av AI-chatboter.
Sammenlignet med modellevaluering
Modellevaluering vurderer svarene fra en modell mot et testdatasett. Benchmarking av AI-agenter sjekker hva agenten faktisk gjorde i ekte verktøy, inkludert riktig arbeid utført på feil sted.
Sammenlignet med agentovervåking
Overvåking, ofte kalt observability, viser hva deres egen agent gjør i produksjon. Benchmarking viser hvordan den står seg mot en konkurrents agent på samme oppgave, noe egne data ikke kan fortelle dere.
FAQ
Svar på de vanligste spørsmålene
Benchmarking av AI-agenter sammenligner to eller flere AI-agenter på de samme oppgavene under identiske forhold, og sjekker hva hver av dem faktisk gjorde i verktøyene den brukte.
Alle bransjer der en AI-agent leser informasjon og utfører handlinger i forretningsverktøy, blant annet bank og finans, helse, kundeservice, reiseliv, IT, salg og produktivitet på arbeidsplassen. Vi bygger testoppgavene rundt det deres egen agent gjør.
Ja. Vi sjekker om agenten oppfatter tale riktig og handler ut fra den, i tillegg til de samme oppgave- og tilgangskontrollene.
Evaluering av AI-agenter vurderer vanligvis svarene til én agent, ofte med et rammeverk som deres eget team kjører. Benchmarking sammenligner to produkter under identiske, dokumenterte forhold og sjekker resultatene i verktøyene de jobbet i. Det er dette som gjør resultatene brukbare i en offentlig sammenligning.
Standardtester sjekker om svaret fra agenten ser riktig ut. En agent kan gi et svar som ser riktig ut, og likevel legge inn feil data, oppdatere feil oppføring, vise innhold til noen som ikke skal se det, eller følge en instruksjon skjult i et dokument. Slike problemer finner man bare ved å sjekke de tilkoblede verktøyene.
Vi gir agenten reelle oppgaver i verktøyene den jobber i, kjører hver oppgave flere ganger fra samme utgangspunkt og sjekker verktøyene før og etter hver kjøring. Resultatene sammenlignes med riktige svar skrevet på forhånd, så vi måler hva agenten faktisk gjorde, ikke bare hva den sa.
Begge produktene kjører på samme abonnement, med samme innhold lastet inn fra én kilde, de samme forespørslene, samme maskinvare og nettverk og ett felles sett med forretningsverktøy. Hver kjøring loggføres i Parity Ledger, som registrerer versjoner, abonnement, innstillinger og testbrukeren som utførte den.
Ja. Vi tester for indirekte prompt injection, der instruksjoner er skjult i innhold agenten leser. Vi tester for det i kundemeldinger, e-poster, delte dokumenter, kalenderinvitasjoner, chat og tilkoblede oppføringer.
Ethvert tilfelle der innhold når en testbruker som ikke har tilgang til det, enten i svaret, en kildehenvisning, en forhåndsvisning, en generert fil eller agentens aktivitetslogg. Målet er null, så vi rapporterer det nøyaktige antallet, ikke en prosentandel.
Vi kjører samme oppgave flere ganger fra samme utgangspunkt, nullstiller alt mellom forsøkene og rapporterer hvor ofte den lykkes. Dette målet kalles pass@k.
Ja, det er det bevispakken er til for. Hvert resultat leveres med Parity Ledger, testinnholdet og de riktige svarene det ble vurdert mot, slik at hvem som helst kan kontrollere det.
Vi rapporterer det og forklarer hvorfor funksjonen ikke kunne testes på det andre produktet. En manglende funksjon er et nyttig funn i seg selv.
To er standard, fordi det er enklest og mest pålitelig å holde forholdene identiske for et par. Flere produkter kan legges til etter avtale.
Etter enhver vesentlig oppdatering av agenten deres eller modellene og integrasjonene den bygger på, og før store salgs- eller sikkerhetsgjennomganger. Mange team kjører også en benchmark hvert kvartal, fordi konkurrenter og underliggende modeller endrer seg av seg selv.
Hvis dere benchmarker deres egen agent: administratortilgang til arbeidsområdet, konkurrenten dere vil sammenligne med, og oppgavene som betyr mest for virksomheten. Hvis dere velger mellom leverandører: prøve- eller pilottilgang til hvert produkt, og oppgavene dere ville brukt dem til. Uansett setter vi opp produktene, bygger testinnholdet og skriver de riktige svarene.