Tjenester
Testing, benchmarking og evaluering av AI-chatboter
Finn ut hvordan chatboten deres faktisk svarer, før kundene eller juridisk avdeling gjør det. Chatbot-testing på enterprise-nivå for samtalebasert kunstig intelligens (AI) og LLM-baserte assistenter, med relevansanalyse, poengsetting av samtaler, deteksjon av hallusinasjoner og benchmarking mot konkurrenter.

Fortune 500-selskaper over hele verden har hatt tillit til oss siden 2011

Hvem det er for
For team som velger en chatbot, og team som drifter en
Enten dere er i ferd med å velge chatbotleverandør eller står ansvarlige for en chatbot som allerede møter kundene, må dere vite hvordan den faktisk svarer.
- Sammenlign chatbotleverandører
Selskaper som skal velge chatbot
Alle leverandørdemoer ser bra ut. Vi tester chatbotene dere vurderer, med deres egne spørsmål og deres eget innhold, og gir hver av dem poeng for hastighet, nøyaktighet og hallusinasjoner, slik at dere velger ut fra dokumentasjon og ikke ut fra demoen.
- Få et estimat
Selskaper som lanserer eller drifter sin egen chatbot
Enten dere har bygget den selv eller konfigurert den på en leverandørplattform, tester vi chatboten før utrulling og på nytt etter hver oppdatering av innholdet eller modellen den kjører på. Når dere trenger dokumentasjon overfor kjøpere, benchmarker vi den mot en konkurrents.
Derfor trenger dere det
En AI-chatbot er bare så god som sitt dårligste svar
Brukerne bedømmer AI-chatboten deres på hastighet og på om de kan stole på det den sier. Ett selvsikkert feil svar kan ødelegge inntrykket av hundre gode.
Folk forventer svar i løpet av sekunder. Hvis chatboten lar dem vente, forlater de chatten eller ringer kundeservice i stedet.
En chatbot som dikter opp en refusjonspolicy eller en produktfunksjon, skaper reelle problemer for supportteamet. Selskaper er allerede blitt holdt juridisk ansvarlige for det chatboten deres har fortalt kundene.
Hvis chatboten kjører på en ekstern AI-modell, kan oppdateringer av modellen endre svarene over natten. Regelmessig testing avdekker det tidlig.
Noen få personer som prøver chatboten en ettermiddag, finner ikke mønstrene. Dere trenger hundrevis av spørsmål, stilt på samme måte hver gang.
Hva vi tester
Grundig testing og evaluering av AI-chatboter
Testing av AI-chatboter dekker hvor godt chatboten yter, hvor gode svarene er, og hvor trygt den oppfører seg. Brukerne merker alle tre delene, så vi måler alle tre, enten chatboten kjører på en generell LLM eller svarer ut fra deres egen kunnskapsbase med retrieval-augmented generation (RAG).
Ytelsestesting av chatboter
Hvor raskt chatboten begynner å svare, hvor lang tid et fullstendig svar tar, og om den forblir pålitelig når det samme spørsmålet stilles igjen og igjen.
Testing av svarkvalitet
Nøyaktigheten, relevansen og fullstendigheten i hvert svar, samt om chatboten dikter opp fakta eller glemmer tidligere deler av samtalen.
Testing av chatbotens sikkerhet og trygghet
Vi prøver å presse chatboten til å ignorere instruksjonene sine, avsløre data eller produsere skadelig innhold, ved hjelp av guardrail-testing og red team-prompter.
Finn svarene dere ikke vil at kundene skal se
Hallusinasjoner, svake svar, prompt injection og ujevn ytelse kan skjule seg bak en håndfull vellykkede samtaler. Vi bygger en testsuite rundt chatboten deres, måler metrikkene som betyr noe, og viser dere hvor den må forbedres.
Metrikker
Evalueringsmetrikkene for AI-chatboter som vi måler
Vi måler ytelse, svarkvalitet og sikkerhet hver for seg, slik at en rask chatbot ikke kan skjule svake svar og en smart chatbot ikke kan skjule risikable svar. Disse chatbotmetrikkene er utgangspunktet.
| Metrikk | Hva den måler |
|---|---|
| Første svartid | Tiden fra et spørsmål sendes til det første tegnet på svar vises på skjermen |
| Svargenereringstid | Tiden AI-en bruker på å produsere et fullstendig svar når den har startet |
| Total svartid | Hele tiden fra spørsmålet sendes til svaret er ferdig |
| Ord per minutt | Hvor raskt svaret dukker opp mens det skrives ut |
| Konsistens | Om chatboten gir et like godt svar når den får det samme spørsmålet flere ganger |
| Metrikk | Hva den måler |
|---|---|
| Poengsum for svarkvalitet | En samlet poengsum for hvert svar på en skala fra 1 til 5 |
| Nøyaktighet | Om faktaene i svaret er korrekte |
| Relevans | Om svaret faktisk besvarer spørsmålet |
| Fullstendighet | Om noe viktig mangler |
| Hallusinasjoner | Om chatboten har diktet opp fakta, retningslinjer eller kilder |
| Konteksthukommelse | Om den husker tidligere meldinger, dokumenter og detaljer fra samtalen |
| Metrikk | Hva den måler |
|---|---|
| Motstand mot prompt injection | Om chatboten holder seg til instruksjonene sine når en bruker prøver å overstyre dem |
| Datalekkasje | Om den avslører systeminstruksjoner, interne data eller andre brukeres opplysninger |
| Emneavgrensning | Om den holder seg innenfor de tiltenkte temaene og avviser forespørsler den ikke skal håndtere |
| Skadelig innhold | Om den produserer noe utrygt, støtende eller i strid med retningslinjene deres |
Vi velger det endelige settet med metrikker sammen med dere, ut fra hva som betyr mest for chatboten deres.
Usikker på hvilke metrikker som betyr mest?
En ingeniør kan gå gjennom hva dere bør måle for chatboten deres. Snakk med en ingeniør.
Slik fungerer poengsettingen
En tydelig poengsum for hvert svar
Hvert svar får en poengsum fra 1 til 5, slik at dere kan sammenligne resultater på tvers av spørsmål, språk, releaser og konkurrerende chatboter.
Slik holder vi poengsummene pålitelige
Vi bruker AI-modeller til å poengsette svar i stor skala, en metode kjent som LLM-as-a-judge, der én stor språkmodell vurderer en annen modells svar opp mot skriftlige kriterier. QA-ingeniørene våre (kvalitetssikring) kontrollerer resultatene og følger en fast gjennomgangsprosess, slik at poengsummene er til å stole på. For å holde dem rettferdige gjør vi følgende:
- Skriver og finjusterer instruksjonene for poengsetting nøye, slik at poengsummene varierer minst mulig
- Poengsetter hvert spørsmål flere ganger for å fjerne avvikende verdier
- Bruker AI-modeller fra ulike leverandører, slik at skjevheten i én enkelt modell ikke påvirker resultatet
- Gjennomfører hver evaluering innenfor et kort tidsvindu, slik at modelloppdateringer ikke forstyrrer sammenligningen
| Poengsum | Betydning |
|---|---|
| 1 | Irrelevant eller feil |
| 2 | Delvis relevant |
| 3 | Relevant, men ufullstendig |
| 4 | Fullstendig og nøyaktig |
| 5 | Eksemplarisk, der dette nivået brukes |
Slik bygger vi testsuiten
Ekte spørsmål, stilt på samme måte hver gang
Vi bygger et sett med spørsmål og samtaler som gjenspeiler hvordan folk faktisk bruker chatboten deres, og kjører det automatisk slik at alle resultater kan sammenlignes.
Forventede spørsmål
Spørsmål om chatbotens hovedoppgave, for eksempel ordrestatus for en shoppingassistent eller kortgrenser for en bankassistent. Dette er kjernen i testen.
Uventede spørsmål
Spørsmål utenfor temaet eller uvanlige spørsmål som en ekte bruker kunne stilt. Vi sjekker om chatboten håndterer dem høflig og holder seg innenfor grensene sine.
Kontekst og hukommelse
Lengre samtaler som tester om chatboten husker hva som ble sagt tidligere, og bruker dokumentene den har fått.
Helautomatiserte kjøringer
Automatisert chatbot-testing sender hvert spørsmål med samme ordlyd og timing i hver kjøring. Det fjerner menneskelige feil og gjør resultatene sammenlignbare mellom releaser og mellom produkter.
Sett chatboten deres på prøve
Se hvordan chatboten håndterer ekte spørsmål, vanskelige samtaler og svarene dere ikke har råd til å få feil. Få tydelig dokumentasjon på hva som fungerer, hva som ikke gjør det, og hva som må endres.
Prosessen vår
Fra avgrensning til poengsummer i fire trinn
Tjenestene våre for testing og evaluering av AI-chatboter følger fire trinn, der teamet deres er involvert i starten og på slutten.
Avgrensning
Vi blir enige om chatbotens formål, språk og metrikkene som betyr noe.
Oppbygging
Vi skriver spørsmålssettet og de riktige svarene, basert på hvordan brukerne deres faktisk snakker med den.
Kjøring og poengsetting
Automatiserte kjøringer, poengsatt med LLM-as-a-judge og kontrollert av QA-ingeniører.
Rapport
Poengsummer, eksempler og en gjennomgang med teamet deres.
Suksesshistorie
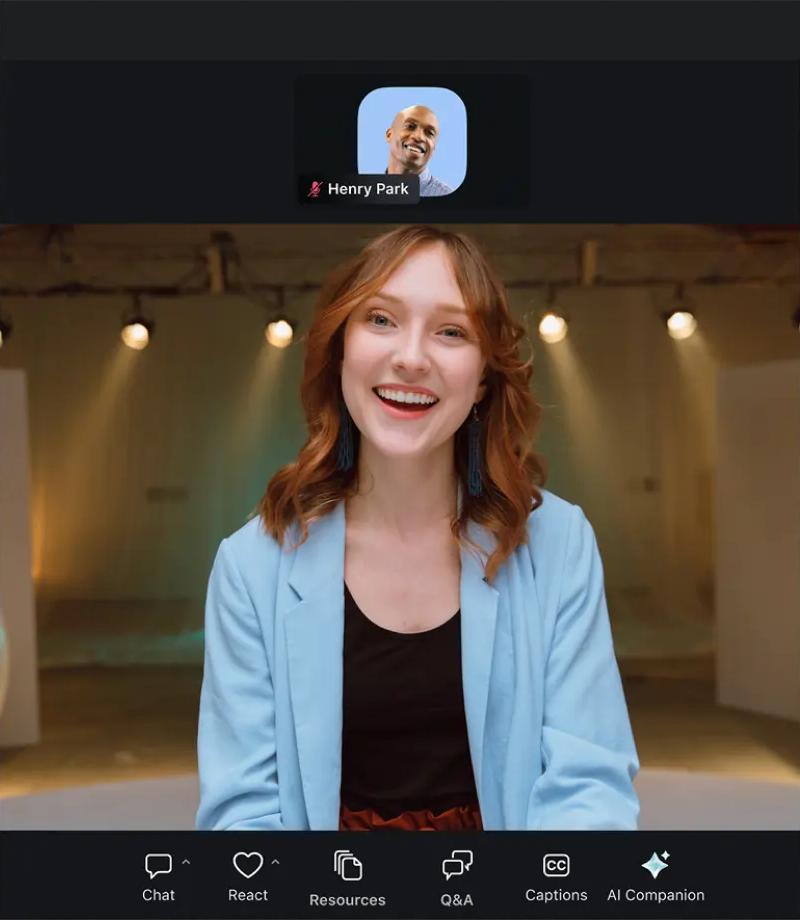
Testingen bak Zoom AI Performance Report 2024
Zoom ba TestDevLab sammenligne AI-funksjonene i ledende møteplattformer. Resultatene ble publisert i Zoom AI Performance Report 2024.
- 3 møteplattformer sammenlignet
- 2 metrikker for samtalebasert AI: svartid og stabilitet
- Testperiode: september 2024
Når dere bør teste og evaluere
Test chatboten før innsatsen øker
Dette er øyeblikkene der et feil svar koster mest, og en rask intern sjekk ikke fanger det opp.
Dere skal snart lansere
Finn de svake svarene før kundene deres gjør det.
AI-modellen er oppdatert
Eksterne modelloppdateringer kan endre svarene over natten.
Innholdet deres er endret
Nye retningslinjer, produkter eller dokumenter endrer hva chatboten bør si.
Dere legger til et språk eller marked
Svarkvaliteten kan falle på et språk chatboten håndterer dårligere.
Dere velger leverandør
Test alternativene med deres egne spørsmål før dere signerer.
- Få et estimat
Lansering eller oppdatering på vei?
Fortell oss hva som endres, så planlegger vi en testrunde rundt det.
Konkurrentanalyse
Benchmark mot konkurrentene deres
Å teste deres egen chatbot forteller dere hvor god den er. Å teste den side om side med en konkurrents forteller dere om den er god nok til å vinne.
Samme spørsmål, samme betingelser
Chatboten deres og en konkurrents får de samme spørsmålene, i samme rekkefølge og under samme betingelser. Det gjør sammenligningen rettferdig.
Poengsummer side om side
Dere får svartider, konsistens og poengsummer for svarkvalitet for hver chatbot, spørsmål for spørsmål.
Hvor dere vinner, og hvor dere ikke gjør det
Resultatene viser nøyaktig hvilke temaer chatboten deres håndterer bedre, og hvor en konkurrent gir sterkere svar.
Samarbeid med TestDevLab
Automatisert i stor skala, kontrollert av eksperter
«Det er ikke realistisk å poengsette tusenvis av chatbotsvar for hånd, og det er det heller ikke å stole på at én AI-modell vurderer en annen uten kontroll. Vi automatiserer kjøringene og poengsettingen og lar deretter QA-ingeniører gå gjennom resultatene, slik at dere får både skala og skjønn i samme rapport. Dere trenger begge deler for å vite hvordan chatboten deres faktisk svarer.»

Direktør for FoU og testautomatisering
- 500+
- erfarne QA-eksperter
- 5000+
- ekte enheter
- 14
- år i QA-bransjen
- 95,6 %
- kundelojalitet
Resultatet
Poengsummer dere kan handle på
Dere får resultatene og svarene bak dem, slik at teamet deres ser nøyaktig hva som må rettes.
I rapporten
- Poengsummer per metrikk, tema, språk og release
- Svartider, med de tregeste spørsmålene markert
- Hver hallusinasjon og hvert sikkerhetsproblem, med spørsmålet som utløste det
- Resultater side om side, hvis en konkurrent ble testet
- Hva som bør rettes først
I datapakken
- Hele spørsmålssettet og de riktige svarene
- Hvert råsvar, lagret slik at resultatene kan poengsettes på nytt senere uten å kjøre testene igjen
- Testet modell- og chatbotversjon med tidsstempel, slik at resultatene kan sammenlignes med fremtidige kjøringer
Se hvordan resultatene ser ut
Få en eksempelrapport fra en tidligere chatbotevaluering. Be om en eksempelrapport.
Det grunnleggende
Hva er testing av AI-chatboter?
Testing av AI-chatboter, også kalt chatbotevaluering eller chatbot-QA, undersøker hvor godt en chatbot besvarer ekte brukerspørsmål. Den måler ytelse, for eksempel svartid og konsistens, og svarkvalitet, for eksempel nøyaktighet, relevans, fullstendighet og om chatboten dikter opp informasjon.
Testing av AI-chatboter er en del av AI-testtjenestene våre.
Sammenlignet med LLM-evaluering
LLM-evaluering poengsetter en modell på et testdatasett, vanligvis før den bygges inn i et produkt. Chatbot-testing undersøker den ferdige chatboten slik brukerne deres møter den, med deres innhold, deres instruksjoner og deres grensesnitt.
Sammenlignet med benchmarking av AI-agenter
En chatbot svarer på spørsmål. En AI-agent utfører også handlinger i forretningsverktøy, for eksempel å oppdatere poster eller utstede refusjoner. For agenter, se benchmarking av AI-agenter.
Se hvilken poengsum AI-chatboten deres får
Fortell oss hva chatboten deres gjør, og hvordan brukerne når den. Vi foreslår et spørsmålssett og metrikkene som betyr noe, og viser dere hvordan den første testrunden vil se ut.
FAQ
Svar på de vanligste spørsmålene
Chatbot-testing undersøker hvor raskt og hvor godt en chatbot besvarer ekte brukerspørsmål, fra svartid og konsistens til nøyaktighet og hallusinasjoner.
Vi bygger et sett med forventede spørsmål, uventede spørsmål og lengre samtaler basert på hvordan brukerne deres faktisk snakker med den. Spørsmålene sendes automatisk, svartidene måles, og hvert svar poengsettes på en skala fra 1 til 5 av AI-modeller, mens QA-ingeniører kontrollerer resultatene.
For ytelse: første svartid, svargenereringstid, total svartid, ord per minutt og konsistens. For svarkvalitet: en samlet kvalitetspoengsum samt nøyaktighet, relevans, fullstendighet, hallusinasjoner og konteksthukommelse. For sikkerhet og trygghet: motstand mot prompt injection, datalekkasje, emneavgrensning og skadelig innhold. Det endelige settet avtaler vi med dere.
Ja. Vi evaluerer svarkvaliteten på hvert språk chatboten deres støtter, også for brukere som skriver på et språk som ikke er morsmålet deres.
Ja. For chatboter som svarer ut fra deres egne dokumenter med retrieval-augmented generation (RAG), sjekker vi om svarene støttes av dokumentene, og markerer alt chatboten legger til på egen hånd.
LLM-as-a-judge er en metode der én stor språkmodell poengsetter en annen modells svar opp mot skriftlige kriterier. Vi bruker modeller fra flere leverandører og lar QA-ingeniører gå gjennom resultatene, slik at poengsummene forblir pålitelige.
Vi sammenligner hvert svar med informasjonen chatboten har lov til å bruke. Ethvert faktum, enhver retningslinje eller kilde som ikke støttes av denne informasjonen, markeres som en hallusinasjon.
Ja. Vi kjører LLM red teaming-prompter som prøver å få chatboten til å ignorere instruksjonene sine, avsløre data eller produsere skadelig innhold, og rapporterer hvor den står imot, og hvor den ikke gjør det.
Ja. Begge chatbotene får de samme spørsmålene under samme betingelser, og dere får poengsummer side om side for hastighet, konsistens og svarkvalitet. Hvis dere skal velge mellom leverandører, kjører vi den samme sammenligningen på chatbotene dere vurderer.
Før lansering, og deretter etter hver vesentlige oppdatering av chatboten, innholdet eller AI-modellen den kjører på. Mange team kjører også en fast sjekk, for eksempel månedlig, fordi eksterne modelloppdateringer kan endre svarene uten at noe er endret hos dere.
Tilgang til chatboten deres, en beskrivelse av hva den er ment å gjøre, og eventuelle dokumenter eller data den bruker for å svare. Vi bygger spørsmålene, kjører testene og poengsetter resultatene.