Kunstig intelligens
Kvalitetskravene i bransjen for kunstig intelligens (AI) settes av brukerne deres, enterprise-kundene deres og myndighetene. Vi hjelper AI-selskaper med å innfri dem gjennom uavhengig validering som har tyngde utenfor egne vegger.
Snakk med en QA-ekspert
Fortune 500-selskaper over hele verden har hatt tillit til oss siden 2011


Slik støtter vi AI-selskaper
Hver fase i kvalitetslivssyklusen til AI-produktet deres, dekket
Fra å validere hvordan produktet deres yter i den virkelige verden til å akselerere de interne prosessene for kvalitetssikring (QA) og integrere AI i testpipelinen. Vi støtter selskaper i AI-bransjen gjennom hele kvalitetsstacken, ikke bare en del av den.
Testing av AI-produkter
Få uavhengig validering av hvor pålitelig AI-produktet deres er i den virkelige verden. Fra LLM-evaluering og hallusinasjonstesting til vurdering av outputkvalitet og konkurrentbenchmarking.
AI-støttet testing
Akselerer de interne QA-prosessene deres med AI-drevet testing med human-in-the-loop. Raskere regresjonssykluser, smartere testutvelgelse og bedre testdekning uten å ansette flere.
AI-integrasjonstjenester
Koble AI-verktøy til testarbeidsflytene utviklerne deres allerede bruker. Vi vurderer pipelinen deres, finner ut hvor AI gir reell effekt, og implementerer det hands-on uten leverandørbinding.
Derfor velger AI-selskaper TestDevLab
Listen for kvaliteten på AI-produkter legges stadig høyere. Vi hjelper dere over den.
Å velge en QA-partner for et AI-produkt er ikke samme beslutning som å velge en for en vanlig programvarelansering. Utfordringene er annerledes, dokumentasjonen som kreves er annerledes, og kostnaden ved å ta feil i produksjon er høyere.
Intern QA forteller dere hvordan produktet yter målt mot deres egne standarder. Uavhengig validering forteller kundene, investorene og myndighetene deres hvordan det yter målt mot en standard de kan stole på. Den forskjellen betyr mer etter hvert som AI-produktet deres skalerer og innsatsen øker.
De fleste QA-leverandører bruker generell testpraksis på AI-produkter. Metodikken vår er bygget spesifikt for probabilistiske resultater, kontekstavhengig kvalitet og variasjon i den virkelige verden. Disse egenskapene gjør at AI-produkter svikter på måter vanlig QA ikke er laget for å fange opp.Se metodikken vi brukte i rapporten Zoom AI Performance Report 2025.
Over 500 QA-ingeniører kjører strukturerte programmer for menneskelig evaluering på tvers av språk, demografi og bruksområder, med en konsistens og dekning som interne gjennomgangsprosesser sjelden oppnår i stort volum uten at det går ut over kvaliteten.
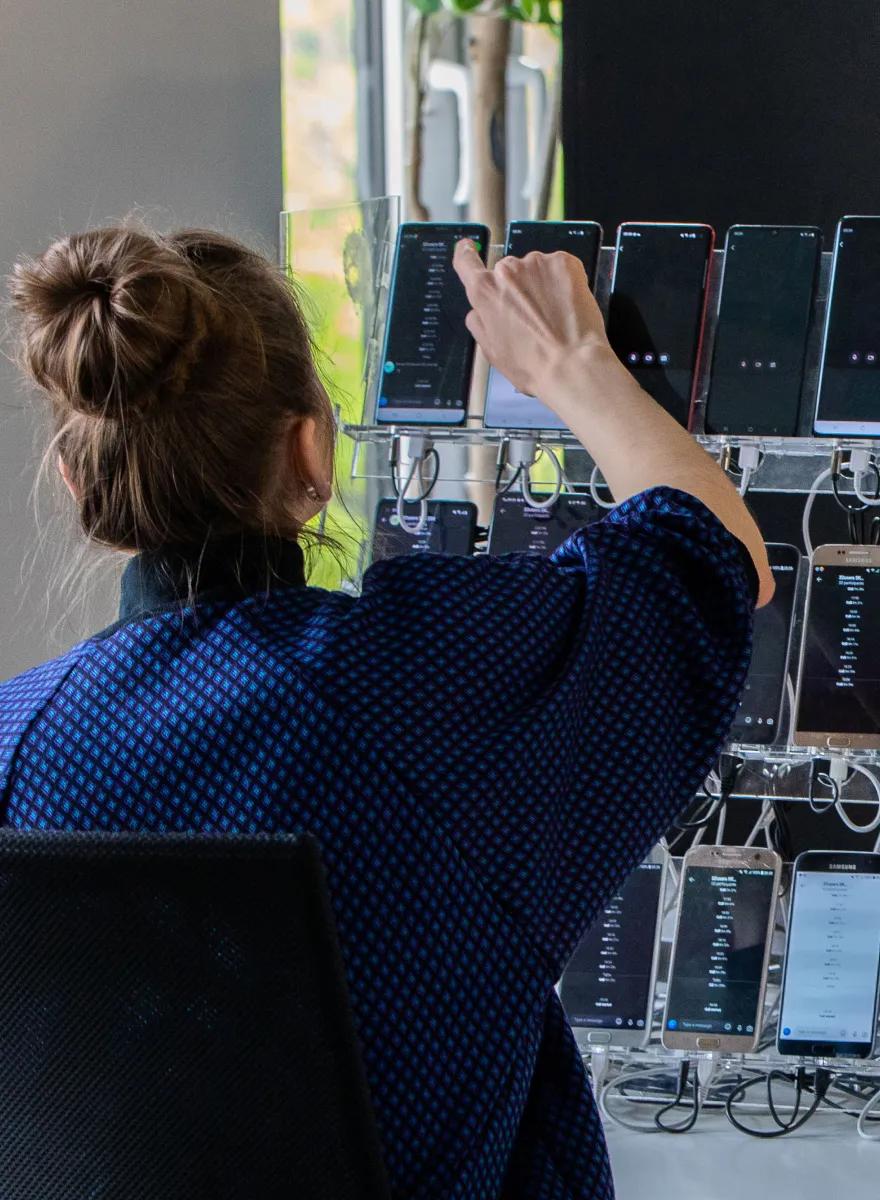
AI-produkter oppfører seg ulikt på tvers av enheter, nettverksforhold, språk og geografi. Testing på over 5 000 ekte enheter, ikke simulatorer, betyr at kvalitetshull som bare viser seg i den virkelige verden, blir funnet før brukerne deres finner dem.
Én QA-partner gjennom hele livssyklusen til AI-produktet, fra datasettkvalitet og evaluering på modellnivå til ende-til-ende-pålitelighet og overvåking i produksjon. Ingen overleveringer, ingen hull og ingen kontekst som går tapt mellom leverandører.
Rapportene er strukturert for å deles eksternt med enterprise-kunder, myndigheter og investorer, ikke bare arkiveres internt. Dette er dokumentasjonen som gjør kvalitet til en kommersiell og compliance-messig styrke, ikke bare et internt måltall.
Hvem vi jobber med
Bygget for selskaper der AI er produktet, ikke bare en funksjon
Teamene vi jobber med, bygger AI inn i kjernen av det de leverer, i stedet for å legge til en AI-funksjon i noe som allerede finnes. For dem er ikke kvalitet en avkrysningsboks. Det er et konkurransefortrinn og et tillitssignal.
AI-startups
Team i tidlig fase som trenger kvalitetsprosesser som skalerer med dem, og uavhengig validering som bygger tillit hos investorer og kunder fra start.
AI-SaaS-selskaper
Abonnementsprodukter der kvaliteten på AI-resultatene direkte styrer kundelojaliteten. Én dårlig opplevelse forsterker seg over tid. Det gjør jevn kvalitet også.
Selskaper innen generativ AI
Produkter der kvaliteten på resultatene er hele verdiforslaget. Kvalitetsvariasjon er ikke en bug – det er en eksistensiell risiko.
Utviklere av AI-agenter
Team som bygger autonome systemer der pålitelighet, forutsigbarhet og trygg oppførsel ved svikt betyr mer enn rå kapasitet.
Tale-AI-selskaper
Produkter som står og faller på gjenkjenningsnøyaktighet, forsinkelse og naturlighet i den virkelige verden, på tvers av hele mangfoldet av ekte brukere.
AI-team i store virksomheter
Interne team som ruller ut AI i enterprise-miljøer der compliance, etterprøvbarhet og jevn ytelse på tvers av komplekse integrasjoner ikke er til forhandling.
Usikker på hvor QA passer inn i veikartet for AI-produktet deres?
Det er riktig utgangspunkt for en samtale.
Utfordringer AI-selskaper møter
Den delen av AI-produktkvalitet ingen liker å snakke om
Dette er utfordringene vi oftest ser hos AI-selskapene vi jobber med. Med riktig QA-partner trenger ingen av dem å bremse dere.
Det som fungerer med noen hundre brukere, slutter å fungere med hundretusener. De fleste AI-selskaper lærer dette på den harde måten. Å bygge kvalitetsprosesser som skalerer med produktet deres, er mye enklere før noe går galt i produksjon enn etterpå.
Enterprise-kunder stiller tøffere spørsmål om kvaliteten på AI-produkter. Egenrapporterte måltall og interne benchmarker holder ikke lenger. Uavhengig validering er i økende grad det som får en avtale videre.
Reguleringen av AI strammes inn i EU, USA og Storbritannia. AI-selskapene som bare tar tak i kvalitet og sikkerhet når det er tid for revisjon, kommer til å få det travelt når kravene skjerpes. Det er enklere å ligge i forkant av reguleringen enn å ta den igjen.
Grunnmodellene produktet deres er bygget på, oppdateres jevnlig. Noen ganger endrer oppdateringene i det stille hvordan produktet oppfører seg, på måter brukerne merker før dere gjør det. De fleste team har ingen pålitelig måte å fange det opp tidlig på.
Står dere i noe av dette akkurat nå? Vi kan hjelpe. Book en gratis konsultasjon

FAQ
Spørsmål vi får fra AI-selskaper før det første oppdraget
Ja. Oppdraget ser bare annerledes ut. Team i tidlig fase trenger som regel lette kvalitetsprosesser og målrettet validering fremfor fullskala programmer. Kartleggingssamtalen er riktig sted å avgrense hva som passer for der dere er.
Ja. Evalueringen vår fokuserer på kvaliteten på resultatene på produktnivå, ikke på modellens indre. Vi trenger ikke tilgang til modellvekter eller treningsdata for å vurdere påliteligheten i den virkelige verden.
Det betyr at funnene våre ikke påvirkes av et kommersielt forhold til modelleverandøren deres, plattformleverandøren deres eller noen annen part med interesse i utfallet. Rapportene våre gjenspeiler det vi finner, og er strukturert for å tåle ekstern gjennomgang.
Alle testdata, resultater og funn håndteres under NDA og kan avgrenses etter kravene deres til datalagringssted og sikkerhet. Evalueringsmiljøer on-premises og i privat sky er tilgjengelige for sensitive bruksområder.
Vi starter med kvalitetsspørsmålene som betyr mest: feiltypene med størst konsekvens for brukerne, scenarioene den interne testingen deres er dårligst rustet til å dekke, og dokumentasjonen kundene deres eller myndighetene mest sannsynlig vil be om.
Bygger dere et produkt i AI-bransjen? La oss snakke kvalitet.
AI-bransjen legger listen høyt for produktkvalitet. Book en gratis kartleggingssamtale for å finne ut hvor produktet deres står, hva uavhengig validering ville dekke, og hvor kvalitetshullene med størst konsekvens ligger.