Tjenester
Benchmarking af AI-agenter
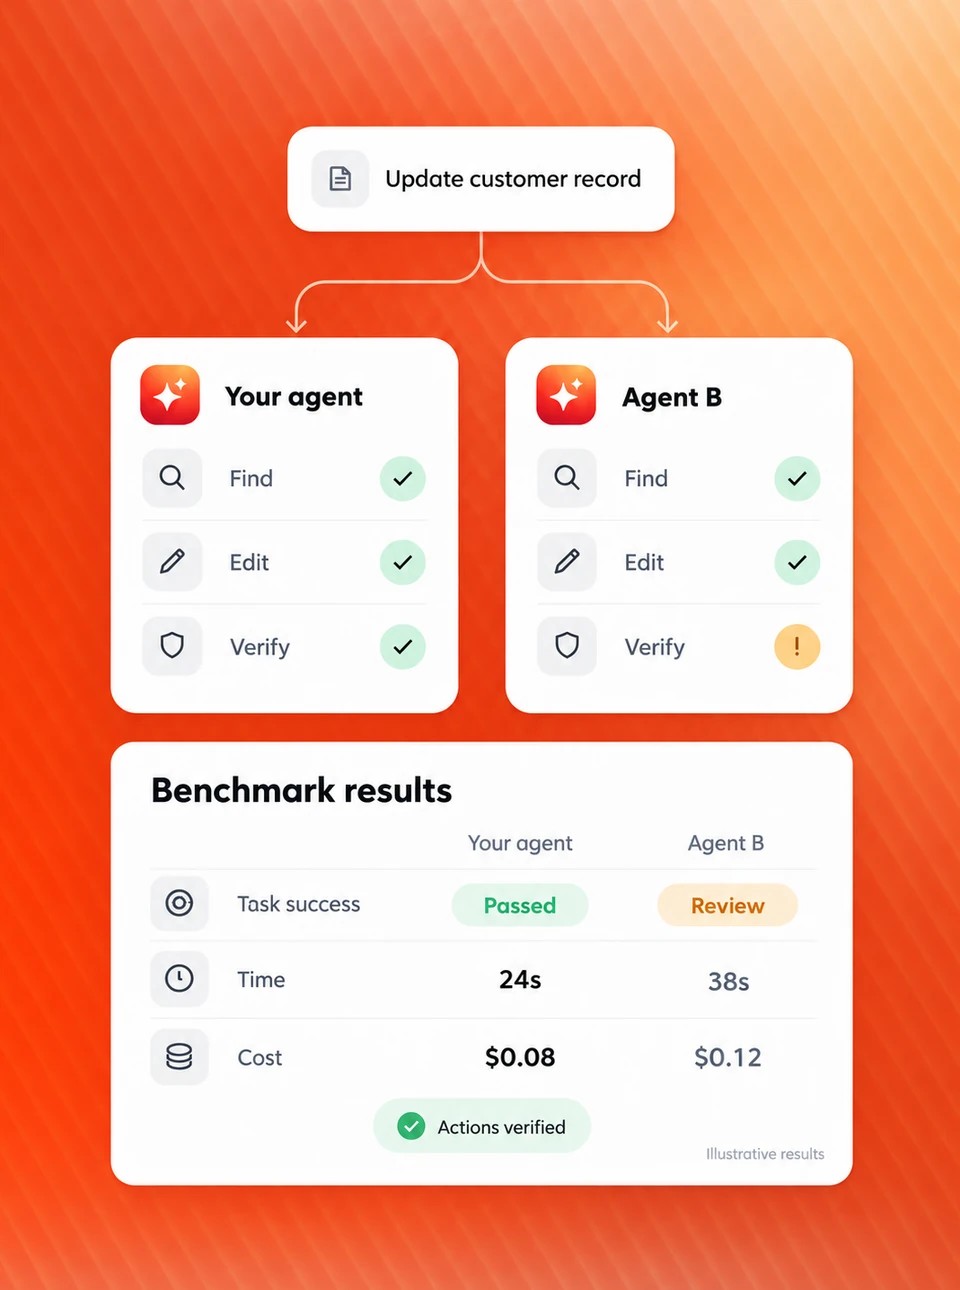
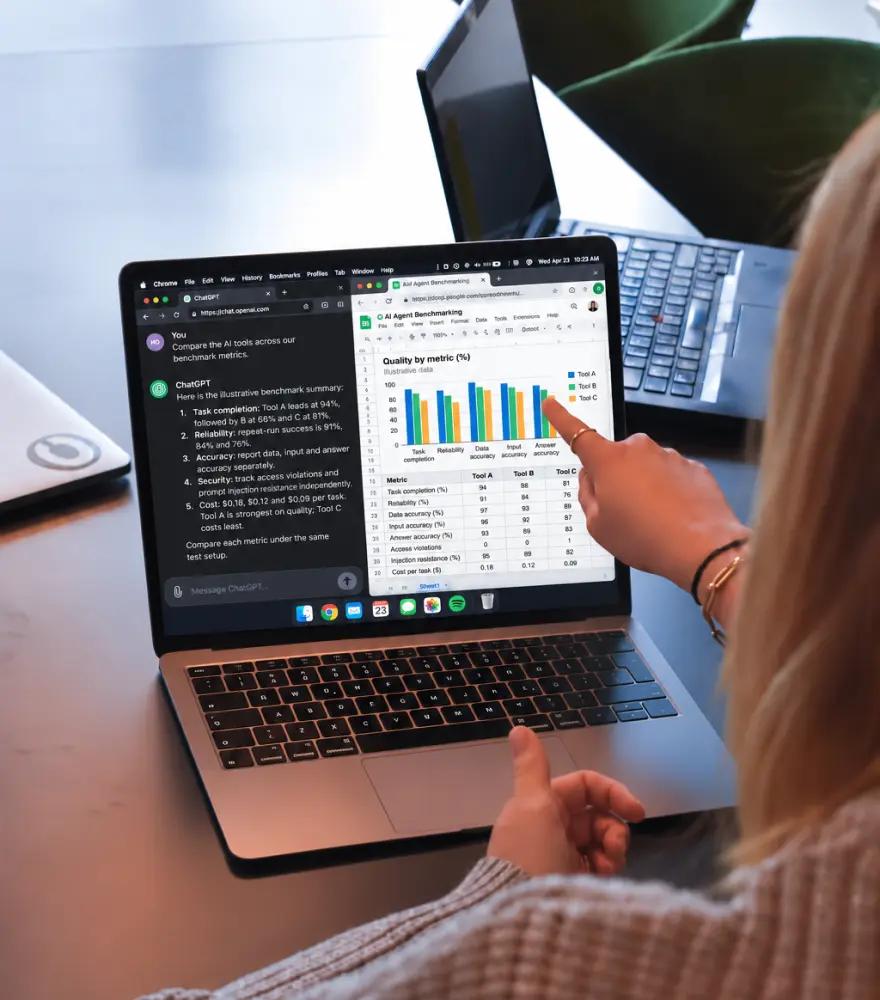
Vi kører din AI-agent og et konkurrerende produkt gennem de samme reelle arbejdsopgaver. Derefter ser vi ind i de værktøjer, hver agent har arbejdet i, for at se, hvad den faktisk gjorde. Du får klare tal for præcision, pålidelighed, sikkerhed og omkostninger.
Fortune 500-virksomheder over hele verden har haft tillid til os siden 2011

Derfor er det vigtigt
Din agent kan ændre sig, uden at du ændrer den
Markedet for AI-agenter flytter sig med få måneders mellemrum. Regelmæssige benchmarks viser, hvilke af dine fordele der stadig holder, og hvor en konkurrent har indhentet dig.
De modeller og integrationer, din agent bygger på, opdateres hele tiden. En agent, der fungerede godt i sidste måned, kan opføre sig anderledes i dag, og en gentaget test viser det tidligt.
En funktion, der adskilte dig for seks måneder siden, kan i dag være noget, alle konkurrenter tilbyder. Benchmarking viser dig, hvilke af dine styrker der stadig holder.
Alle leverandører siger, at deres agent er præcis og sikker. Uafhængige resultater giver køberne noget solidt at sammenligne, og dit salgsteam får beviser at dele.
Offentlige tests, der sammenligner AI-agenter, tjekker ofte produkterne på hver sin måde, så resultaterne siger meget lidt. Vi bruger én metode til begge produkter.
Hvem det er til
Til teams, der vælger en AI-agent, og teams, der bygger en
Uanset om du køber en agent eller lancerer en, har du brug for dokumentation, der holder uden for dit eget team.
- Sammenlign AI-agenter
Virksomheder, der vælger mellem AI-agenter
Alle leverandører siger, at deres agent er præcis og sikker. Vi sammenligner AI-agenter på dine egne opgaver i dine egne værktøjer og viser, hvilken der faktisk får arbejdet gjort uden at indtaste forkerte data eller lække adgang. Brug resultaterne i indkøb, sikkerhedsgennemgange og beslutninger om pilotprojekter.
- Få et estimat
Virksomheder, der udvikler deres egen AI-agent
Du har brug for at vide, hvordan din agent præsterer, og hvordan den klarer sig mod konkurrenterne. Vi tester din agent alene før lancering eller efter en modelopdatering og benchmarker den direkte mod konkurrenten, når du har brug for beviser over for købere.
Det får I
Resultater, som alle teams kan bruge
Vores tjenester til benchmarking af AI-agenter giver dit produktteam klare kvalitetsdata og dit salgsteam beviser, de kan lægge frem for købere. Hvis du vælger mellem agenter, får du den samme dokumentation til dit leverandørvalg og din sikkerhedsgennemgang.
Til dit produktteam
Hvor du står i dag
Hvordan din agent præsterer mod konkurrenterne på de samme opgaver, opdateret ved hver testcyklus.
Tidlig advarsel, når kvaliteten falder
Når en underliggende model eller integration ændres, viser den næste kørsel, hvad der er blevet dårligere, og hvor meget.
Svar til sikkerhedsgennemgange
Klare resultater for forkerte data, adgangslæk og prompt injection, de tre ting, som enterprise-købere oftest spørger om.




Til dit salgsteam
Resultater, du kan publicere
Hvert resultat leveres med dokumentation af, hvordan testen blev sat op, så kunderne selv kan tjekke det.
Beviser bag dine påstande
Dokumentation for netop de punkter, dit salgsoplæg afhænger af, opdateret i takt med at markedet flytter sig.
Besked, når en konkurrent trækker fra
Du ser det, mens der stadig er tid til at reagere i din næste release.
Se, hvordan din AI-agent reelt præsterer
Få klar dokumentation for præcision, pålidelighed og sikkerhed på de opgaver, der betyder noget for dit team.
Det vurderer vi
Find ud af, hvor kvaliteten af din AI-agent svigter
En agents kvalitet består af mindst fem dele, og hver af dem kan fejle for sig. En agent kan tage perfekte mødenoter og alligevel opdatere den forkerte kundepost.
Forståelse af input
Læser den dokumenter, beskeder, formularer, data og tale korrekt, og bruger den kun det, der faktisk står der?
Opgaveløsning
Løser den opgaven korrekt i de værktøjer, den arbejder i? Vi tjekker selve værktøjerne, ikke kun agentens svar.
Pålidelighed og hastighed
Løser den den samme opgave rigtigt hver gang, og hvor længe skal brugeren vente?
Sikkerhed og compliance
Respekterer den adgangsrettigheder, ignorerer den skjulte instruktioner, og håndterer den følsomme data, som reglerne i din branche kræver?
Brugervenlighed
Hvor meget skal brugeren anstrenge sig for at få et brugbart resultat? Målt objektivt.
- Få et estimat
Har du et projekt i tankerne?
Fortæl os, hvad du planlægger. Vi hjælper dig med at tage det næste skridt.
Hvornår du har brug for det
Benchmark din AI-agent, før der står mere på spil
De fleste teams kommer til os, når noget snart skal afgøres. En aftale, en gennemgang, en lancering. Hver af dem kræver uafhængig dokumentation fra nogen uden for dit eget team.
Enterprise-købere vil vide, hvordan din agent håndterer adgangsrettigheder og skjulte instruktioner. Vores resultater giver dem tal at vurdere, ikke kun et politikdokument.
En markedsføringspåstand, der bygger på en dokumenteret test, holder. En uden bliver ofte udfordret, gerne af den konkurrent, du nævnte.
Din agents adfærd kan ændre sig, uden at nogen på dit team rører koden. En testkørsel viser præcis, hvad der har ændret sig.
Giv deres evalueringsteam én fair metode anvendt på begge produkter, med resultater, de kan handle ud fra. Det er i dag et fast trin i enterprise-indkøb.
Find ud af, hvor godt det førende produkt reelt præsterer, før du lægger din roadmap efter det.
Står du over for et af disse øjeblikke?
Fortæl os, hvad der står for døren, så tilrettelægger vi en benchmark omkring det. Få et estimat
Dækning
AI-agenter, vi benchmarker
Fra kundesupport til søgning i virksomhedens viden tester vi agenter, der læser information og udfører handlinger i forretningsværktøjer.
| Type AI-agent | Typiske opgaver, vi tester |
|---|---|
| Kundesupport | Læse tickets, opdatere konti, udstede refusioner, skrive udkast til svar |
| Bank og finans | Tjekke transaktioner, udarbejde rapporter, besvare spørgsmål om konti inden for adgangsreglerne |
| Sundhedsadministration | Booke aftaler, opsummere journaler, håndtere patientdata under strenge adgangsregler |
| Salg og CRM | Opdatere deals, registrere opkald, skrive udkast til opfølgninger |
| IT og intern helpdesk | Håndtere adgangsanmodninger, oprette tickets, besvare spørgsmål om politikker |
| Rejser og booking | Finde muligheder, ændre bookinger, anvende takstregler og virksomhedens rejseregler |
| Møder og produktivitet | Transskriptioner, resuméer, handlingspunkter, dokumenter og præsentationer |
| Søgning i virksomhedsviden | Finde svar på tværs af filer, poster og chats og samtidig respektere, hvem der må se hvad |
Mål, hvordan din AI-agent præsterer
Test præcision, pålidelighed og sikkerhed på de opgaver, der betyder noget for dit team.
Metrikker
Metrikker til benchmarking af AI-agenter, målt hver for sig
Hver evalueringsmetrik for AI-agenter rapporteres for sig sammen med den opsætning, den blev testet under, så intet svagt punkt gemmer sig i en gennemsnitsscore.
| Metrik | Hvad den tjekker |
|---|---|
| Opgaveløsning | Løste agenten opgaven korrekt? Tjekket i det værktøj, den arbejdede i |
| Pålidelighed | Lykkes den hver gang? Testet med gentagne forsøg fra samme udgangspunkt og rapporteret som pass@k |
| Datapræcision | Indtastede den forkerte eller opdigtede data, eller sendte den noget det forkerte sted hen? |
| Adgangskontrol | Så nogen indhold, de ikke måtte se? Målet er nul |
| Modstandsdygtighed over for prompt injection | Kan instruktioner skjult i en besked, en e-mail eller et dokument ændre, hvad agenten gør? Det kaldes indirekte prompt injection |
| Inputpræcision | Læste den dokumenter, formularer og beskeder korrekt, og hørte den tale korrekt, hvor der bruges stemme? |
| Svarpræcision | Bruger svaret eller resuméet kun det, der står i kilden, uden noget opdigtet og uden at noget vigtigt mangler? |
| Omkostninger | Hvad kostede arbejdet på hvert produkt i tokens og penge? Hentet fra hvert produkts egen fakturering |
I tvivl om, hvilke metrikker der betyder mest?
En ingeniør kan hjælpe dig med at finde ud af, hvad du bør måle for din type agent. Tal med en ingeniør.
Arbejdsgang
Automatiseret og manuel test, gentagelig og tjekket mod det rigtige svar
Hver test afvikles på nøjagtig samme måde på begge produkter, hver gang. Det kræver automatisering, med manuelle trin kun hvor et produkt gør det nødvendigt.
- 1
Automatiseret på begge produkter
Begge produkter styres af testautomatisering, uanset om de kører i en browser, en desktopapp eller et chatvindue, så hvert produkt får nøjagtigt det samme input ved hver kørsel.
- 2
Øjebliksbilleder før og efter
Vi registrerer tilstanden i hvert tilknyttet værktøj før og efter hver kørsel og sammenligner derefter de to automatisk.
- 3
Tjekket mod det rigtige svar
Hvert output sammenlignes med det korrekte svar, der er skrevet på forhånd. Poster tjekkes i værktøjet, tal genberegnes uafhængigt, og tekst scores af en AI-model, en metode kendt som LLM-as-a-judge. Til mødeindhold gør vores eget værktøj MOSAIC dette i stor skala.
- 4
Scorer, du kan reproducere
Scoringsinstruktionerne for hver metrik er versionsstyrede, så enhver score kan reproduceres eller genberegnes senere, hvis en metrik ændres.
- 5
Mange gentagelser, ikke én kørsel
Hver opgave køres flere gange, og scoringen sker i batches på tusindvis, så vi ved, hvor konsistent agenten er, i stedet for at gætte.
Vores proces
Fra afgrænsning til rapport i fire trin
Vores tjenester til benchmarking af AI-agenter følger fire trin, hvor dit team er involveret i starten og i slutningen.
Afgrænsning
Vi aftaler konkurrenten, opgaverne og metrikkerne med dig.
Opsætning
Vi sætter begge produkter op, indlæser identisk indhold og skriver de korrekte svar.
Kørsler
Automatiserede kørsler på begge produkter, gentaget og logget i Parity Ledger.
Rapport
Resultater, evidenspakken og en gennemgang med dit team.
Find ud af, hvor din AI-agent står
Nævn konkurrenten og de opgaver, der betyder noget. Vi bygger en fair, gentagelig benchmark og giver dig resultater, du kan handle ud fra og publicere.
Eksempler
Virkelige opgaver, vi tester
Vi bygger hver benchmark op omkring de opgaver, din egen agent håndterer. Eksemplerne viser, hvilken slags arbejde vi tester på tværs af brancher.
Kundehenvendelse fra start til slut
Agenten læser en supportticket, opdaterer kundeposten, tjekker ordre- og faktureringsstatus og skriver et udkast til et svar.
Ændring af en aftale
En patient beder om at flytte en aftale. Agenten finder en ny tid, opdaterer bookingen og bekræfter den uden at afsløre oplysninger om andre patienter.
Spørgsmål med begrænset adgang
En medarbejder spørger om noget, hvor det bedste svar findes i indhold, vedkommende ikke må se.
Indsigelse mod en betaling
En kunde gør indsigelse mod en kortbetaling. Agenten tjekker transaktionen, anvender bankens politik, opdaterer kontoen og bekræfter udfaldet.
Fra møde til tickets
Et opkald finder sted. Agenten skriver noter, beslutninger og handlingspunkter, opretter tickets og returnerer linkene.
Fra dokument til rapport
En kontrakt og en projektspecifikation går ind. Et kort resumé og en statusrapport kommer ud.
Resultatet
En rapport og dokumentationen bag den
Rapporten giver dig resultaterne. Med evidenspakken kan alle tjekke dem, og det er det, der gør resultaterne sikre at publicere.
I rapporten
- Resultater for hver metrik med den opsætning, den blev testet under
- Resultater for hver opgave med outputtet og de ændringer i værktøjerne, der beviser det
- Enhver funktion, der ikke kunne testes på et af produkterne, og hvorfor
- Steder, hvor en leverandørs dokumentation siger én ting, og produktet gør noget andet
I evidenspakken
- Parity Ledger for hver testkørsel
- Alt testindhold og de korrekte svar, hvert resultat blev scoret op imod
- Alle rå outputs, gemt så metrikker kan genscores senere uden at køre testene igen
Se, hvordan dokumentationen ser ud
Få en eksempelrapport og en Parity Ledger fra en tidligere benchmark. Bed om en eksempelrapport.
Samarbejd med TestDevLab
Benchmarks bygget til at holde
»Det første, nogen gør med et benchmarkresultat, de ikke kan lide, er at sætte spørgsmålstegn ved metoden. Derfor kører vi begge agenter på den samme plan, med det samme indhold og under de samme forhold, logger hver kørsel i Parity Ledger og tjekker de værktøjer, hver agent har arbejdet i, ikke kun dens svar. Vores resultater holder, fordi metoden gør.«

Direktør for high tech-innovation og testdrift
- 500+
- erfarne QA-eksperter
- 5000+
- rigtige enheder
- 14
- år i QA-branchen
- 95,6 %
- kundefastholdelse
Det grundlæggende
Hvad er benchmarking af AI-agenter?
Benchmarking af AI-agenter betyder, at to eller flere AI-agenter får de samme opgaver under de samme forhold, hvorefter man tjekker de værktøjer, hver agent har arbejdet i, for at se, hvad den faktisk gjorde. Det giver sammenlignelige resultater for opgaveløsning, pålidelighed, datapræcision, adgangskontrol, modstandsdygtighed over for prompt injection og omkostninger.
Det er en del af vores bredere AI-testservices, herunder vores tjenester til test og evaluering af AI-chatbots.
Sammenlignet med modelevaluering
Modelevaluering scorer en models svar mod et testdatasæt. Benchmarking af AI-agenter tjekker, hvad agenten faktisk gjorde i rigtige værktøjer, herunder korrekt arbejde udført det forkerte sted.
Sammenlignet med agentovervågning
Overvågning, ofte kaldet observability, viser, hvad din egen agent gør i produktion. Benchmarking viser, hvordan den klarer sig mod en konkurrents agent på den samme opgave, og det kan dine egne data ikke fortælle dig.
FAQ
Svar på de mest stillede spørgsmål
Benchmarking af AI-agenter sammenligner to eller flere AI-agenter på de samme opgaver under identiske forhold og tjekker, hvad hver af dem faktisk gjorde i de værktøjer, den brugte.
Alle brancher, hvor en AI-agent læser information og udfører handlinger i forretningsværktøjer, herunder bank og finans, sundhed, kundesupport, rejser, IT, salg og produktivitet på arbejdspladsen. Vi bygger testopgaverne op omkring det, din egen agent gør.
Ja. Vi tjekker, om agenten opfatter tale korrekt og handler ud fra den, sammen med de samme tjek af opgaver og adgang.
Evaluering af AI-agenter scorer typisk én agents svar, ofte med et framework, som dit eget team kører. Benchmarking sammenligner to produkter under identiske, dokumenterede forhold og tjekker resultaterne i de værktøjer, de arbejdede i. Det er det, der gør resultaterne brugbare i en offentlig sammenligning.
Almindelige tests tjekker, om agentens svar ser rigtigt ud. En agent kan give et svar, der ser korrekt ud, og alligevel indtaste forkerte data, opdatere den forkerte post, vise indhold til nogen, der ikke må se det, eller følge en instruktion skjult i et dokument. Du finder kun de problemer ved at tjekke de tilknyttede værktøjer.
Vi giver agenten rigtige opgaver i de værktøjer, den arbejder i, kører hver opgave flere gange fra samme udgangspunkt og tjekker værktøjerne før og efter hver kørsel. Outputs sammenlignes med korrekte svar, der er skrevet på forhånd, så vi måler, hvad agenten faktisk gjorde, ikke kun hvad den sagde.
Begge produkter kører på samme abonnement, med det samme indhold indlæst fra én kilde, de samme forespørgsler, samme hardware og netværk og ét fælles sæt forretningsværktøjer. Hver kørsel logges i Parity Ledger, som registrerer versioner, abonnement, indstillinger og den testbruger, der udførte kørslen.
Ja. Vi tester for indirekte prompt injection, hvor instruktioner er skjult i indhold, agenten læser. Vi tester for det i kundebeskeder, e-mails, delte dokumenter, kalenderinvitationer, chat og tilknyttede poster.
Ethvert tilfælde, hvor indhold når en testbruger, der ikke må se det, uanset om det er i svaret, en kildehenvisning, en forhåndsvisning, en genereret fil eller agentens aktivitetslog. Målet er nul, så vi rapporterer det præcise antal, ikke en procentdel.
Vi kører den samme opgave flere gange fra samme udgangspunkt, nulstiller alt mellem forsøgene og rapporterer, hvor ofte den lykkes. Målingen kaldes pass@k.
Ja, det er netop det, evidenspakken er til. Hvert resultat leveres med Parity Ledger, testindholdet og de korrekte svar, det blev scoret op imod, så alle kan tjekke det.
Vi rapporterer det og forklarer, hvorfor den ikke kunne testes på det andet produkt. En manglende funktion er i sig selv et nyttigt fund.
To er standardsammenligningen, fordi det er lettest og mest pålideligt at holde forholdene identiske for et par. Flere produkter kan tilføjes efter aftale.
Efter enhver væsentlig opdatering af jeres agent eller de modeller og integrationer, den bygger på, og før større salgs- eller sikkerhedsgennemgange. Mange teams kører også en benchmark hvert kvartal, fordi konkurrenter og underliggende modeller ændrer sig af sig selv.
Hvis I benchmarker jeres egen agent: administratoradgang til jeres workspace, den konkurrent, I vil sammenlignes med, og de opgaver, der betyder mest for jeres forretning. Hvis I vælger mellem leverandører: prøve- eller pilotadgang til hvert produkt og de opgaver, I vil bruge dem til. Uanset hvad sætter vi produkterne op, bygger testindholdet og skriver de korrekte svar.