Services
Test, benchmarking og evaluering af AI-chatbots
Find ud af, hvordan jeres chatbot faktisk svarer, før jeres kunder eller juridiske afdeling gør det. Chatbot-test på enterprise-niveau til konversationel AI og LLM-baserede assistenter med relevansanalyse, scoring af samtaler, detektering af hallucinationer og benchmarks mod konkurrenter.

Fortune 500-virksomheder over hele verden har haft tillid til os siden 2011

Hvem det er til
Til teams, der skal vælge en chatbot, og teams, der driver en
Uanset om I er ved at vælge en chatbotleverandør eller står til ansvar for en chatbot, der allerede møder kunderne, har I brug for at vide, hvordan den faktisk svarer.
- Sammenlign chatbotleverandører
Virksomheder, der skal vælge en chatbot
Alle leverandørdemoer ser godt ud. Vi tester de chatbots, I overvejer, med jeres egne spørgsmål og jeres eget indhold og scorer hver enkelt på hastighed, nøjagtighed og hallucinationer, så I vælger ud fra dokumentation og ikke ud fra demoen.
- Få et estimat
Virksomheder, der lancerer eller driver deres egen chatbot
Uanset om I selv har bygget den eller konfigureret den på en leverandørplatform, tester vi jeres chatbot, inden den går i drift, og igen efter hver opdatering af indholdet eller den model, den kører på. Når I skal kunne dokumentere kvaliteten over for købere, benchmarker vi den mod en konkurrents.
Derfor har I brug for det
En AI-chatbot er kun så god som sit dårligste svar
Brugerne bedømmer jeres AI-chatbot på hastighed og på, om de kan stole på det, den siger. Ét selvsikkert forkert svar kan ødelægge indtrykket af hundrede gode.
Folk forventer svar inden for få sekunder. Hvis jeres chatbot lader dem vente, forlader de chatten eller ringer til jeres support i stedet.
En chatbot, der opfinder en refusionspolitik eller en produktfunktion, skaber reelle problemer for jeres supportteam. Virksomheder er allerede blevet holdt juridisk ansvarlige for det, deres chatbot har fortalt kunderne.
Hvis jeres chatbot kører på en ekstern AI-model, kan opdateringer af modellen ændre svarene fra den ene dag til den anden. Regelmæssig test viser det tidligt.
Nogle få personer, der prøver chatbotten en eftermiddag, finder ikke mønstrene. Der skal hundredvis af spørgsmål til, stillet på samme måde hver gang.
Hvad vi tester
Dybdegående test og evaluering af AI-chatbots
Test af AI-chatbots dækker, hvor godt chatbotten performer, hvor gode dens svar er, og hvor sikkert den opfører sig. Brugerne mærker alle tre dele, så vi måler alle tre, uanset om jeres chatbot kører på en generel LLM eller svarer ud fra jeres egen vidensbase med retrieval-augmented generation (RAG).
Performancetest af chatbots
Hvor hurtigt chatbotten begynder at svare, hvor lang tid et fuldt svar tager, og om den forbliver pålidelig, når det samme spørgsmål stilles igen og igen.
Test af svarkvalitet
Nøjagtigheden, relevansen og fuldstændigheden af hvert svar, samt om chatbotten opfinder fakta eller glemmer tidligere dele af samtalen.
Test af chatbottens sikkerhed og tryghed
Vi forsøger at presse chatbotten til at ignorere sine instruktioner, afsløre data eller producere skadeligt indhold ved hjælp af guardrail-test og red team-prompts.
Find de svar, I ikke ønsker, at kunderne skal se
Hallucinationer, svage svar, prompt injection og svingende performance kan gemme sig bag en håndfuld vellykkede samtaler. Vi bygger en testsuite omkring jeres chatbot, måler de metrikker, der betyder noget, og viser jer, hvor den skal forbedres.
Metrikker
De evalueringsmetrikker for AI-chatbots, vi måler
Vi måler performance, svarkvalitet og sikkerhed hver for sig, så en hurtig chatbot ikke kan skjule svage svar, og en klog chatbot ikke kan skjule risikable svar. Disse chatbotmetrikker er udgangspunktet.
| Metrik | Hvad den måler |
|---|---|
| Første svartid | Tiden fra et spørgsmål sendes, til det første tegn på et svar vises på skærmen |
| Svargenereringstid | Den tid, AI'en bruger på at producere et komplet svar, når den er gået i gang |
| Samlet svartid | Den fulde tid fra spørgsmålet sendes, til svaret er færdigt |
| Ord pr. minut | Hvor hurtigt svaret dukker op, mens det skrives ud |
| Konsistens | Om chatbotten giver et lige så godt svar, når den får det samme spørgsmål flere gange |
| Metrik | Hvad den måler |
|---|---|
| Score for svarkvalitet | En samlet score for hvert svar på en skala fra 1 til 5 |
| Nøjagtighed | Om fakta i svaret er korrekte |
| Relevans | Om svaret faktisk besvarer spørgsmålet |
| Fuldstændighed | Om der mangler noget vigtigt |
| Hallucinationer | Om chatbotten har opfundet fakta, politikker eller kilder |
| Konteksthukommelse | Om den husker tidligere beskeder, dokumenter og detaljer fra samtalen |
| Metrik | Hvad den måler |
|---|---|
| Modstandsdygtighed over for prompt injection | Om chatbotten holder sig til sine instruktioner, når en bruger forsøger at tilsidesætte dem |
| Datalækage | Om den afslører systeminstruktioner, interne data eller andre brugeres oplysninger |
| Emneafgrænsning | Om den holder sig inden for sine tiltænkte emner og afviser forespørgsler, den ikke bør håndtere |
| Skadeligt indhold | Om den producerer noget usikkert, stødende eller i strid med jeres politikker |
Vi vælger det endelige sæt metrikker sammen med jer ud fra, hvad der betyder mest for jeres chatbot.
I tvivl om, hvilke metrikker der betyder mest?
En ingeniør kan gennemgå med jer, hvad I bør måle for jeres chatbot. Tal med en ingeniør.
Sådan fungerer scoringen
En klar score for hvert svar
Hvert svar får en score fra 1 til 5, så I kan sammenligne resultater på tværs af spørgsmål, sprog, releases og konkurrerende chatbots.
Sådan holder vi scorerne pålidelige
Vi bruger AI-modeller til at score svar i stor skala, en metode kendt som LLM-as-a-judge, hvor én stor sprogmodel bedømmer en anden models svar ud fra nedskrevne kriterier. Vores QA-ingeniører (kvalitetssikring) kontrollerer resultaterne og følger en fast reviewproces, så man kan stole på scorerne. For at holde dem fair gør vi følgende:
- Skriver og finjusterer scoringsinstruktionerne omhyggeligt, så scorerne varierer så lidt som muligt
- Scorer hvert spørgsmål flere gange for at fjerne afvigende værdier
- Bruger AI-modeller fra forskellige leverandører, så ingen enkelt models bias skævvrider resultatet
- Gennemfører hver evaluering inden for et kort tidsrum, så modelopdateringer ikke forvrænger sammenligningen
| Score | Betydning |
|---|---|
| 1 | Irrelevant eller forkert |
| 2 | Delvist relevant |
| 3 | Relevant, men ufuldstændigt |
| 4 | Fuldstændigt og nøjagtigt |
| 5 | Eksemplarisk, hvor dette niveau bruges |
Opbygning af testsuiten
Rigtige spørgsmål, stillet på samme måde hver gang
Vi opbygger et sæt spørgsmål og samtaler, der afspejler, hvordan folk faktisk bruger jeres chatbot, og kører det automatisk, så alle resultater kan sammenlignes.
Forventede spørgsmål
Spørgsmål om chatbottens hovedopgave, f.eks. ordrestatus for en shoppingassistent eller kortgrænser for en bankassistent. Det er kernen i testen.
Uventede spørgsmål
Spørgsmål uden for emnet eller usædvanlige spørgsmål, som en rigtig bruger kunne stille. Vi tjekker, om chatbotten håndterer dem høfligt og holder sig inden for sine grænser.
Kontekst og hukommelse
Længere samtaler, der tester, om chatbotten husker, hvad der blev sagt tidligere, og bruger de dokumenter, den har fået.
Fuldt automatiserede kørsler
Automatiseret chatbot-test sender hvert spørgsmål med samme ordlyd og timing i hver kørsel. Det fjerner menneskelige fejl og gør resultaterne sammenlignelige mellem releases og mellem produkter.
Sæt jeres chatbot på prøve
Se, hvordan jeres chatbot håndterer rigtige spørgsmål, svære samtaler og de svar, I ikke har råd til at få forkert. Få klar dokumentation for, hvad der virker, hvad der ikke gør, og hvad der skal ændres.
Vores proces
Fra afgrænsning til scorer i fire trin
Vores services inden for test og evaluering af AI-chatbots følger fire trin, hvor jeres team er involveret i starten og til sidst.
Afgrænsning
Vi aftaler chatbottens formål, sprog og de metrikker, der betyder noget.
Opbygning
Vi skriver spørgsmålssættet og de korrekte svar ud fra, hvordan jeres brugere faktisk taler med den.
Kørsel og scoring
Automatiserede kørsler, scoret med LLM-as-a-judge og kontrolleret af QA-ingeniører.
Rapport
Scorer, eksempler og en gennemgang med jeres team.
Succeshistorie
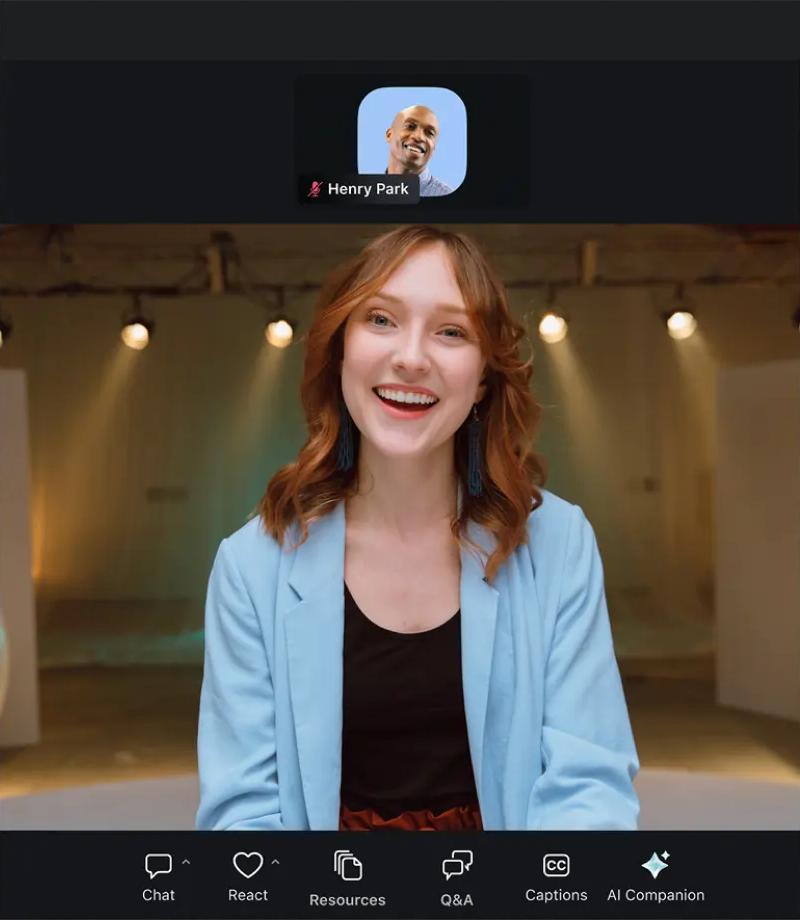
Testen bag Zoom AI Performance Report 2024
Zoom bad TestDevLab om at sammenligne AI-funktionerne i førende mødeplatforme. Resultaterne blev offentliggjort i Zoom AI Performance Report 2024.
- 3 mødeplatforme sammenlignet
- 2 metrikker for konversationel AI: svartid og stabilitet
- Testperiode: september 2024
Hvornår I bør teste og evaluere
Test jeres chatbot, før indsatsen stiger
Det er i disse øjeblikke, et forkert svar koster mest, og et hurtigt internt tjek ikke fanger det.
I står over for en lancering
Find de svage svar, før jeres kunder gør.
AI-modellen er blevet opdateret
Eksterne modelopdateringer kan ændre svarene fra den ene dag til den anden.
Jeres indhold har ændret sig
Nye politikker, produkter eller dokumenter ændrer, hvad chatbotten bør sige.
I tilføjer et sprog eller et marked
Svarkvaliteten kan falde på et sprog, som chatbotten håndterer mindre godt.
I er ved at vælge leverandør
Test mulighederne med jeres egne spørgsmål, før I skriver under.
- Få et estimat
Foran en lancering eller opdatering?
Fortæl os, hvad der ændrer sig, så tilrettelægger vi en testrunde omkring det.
Konkurrentanalyse
Benchmark mod jeres konkurrenter
Når I tester jeres egen chatbot, ved I, hvor god den er. Når I tester den side om side med en konkurrents, ved I, om den er god nok til at vinde.
Samme spørgsmål, samme betingelser
Jeres chatbot og en konkurrents får de samme spørgsmål i samme rækkefølge og under samme betingelser. Det gør sammenligningen fair.
Scorer side om side
I får svartider, konsistens og scorer for svarkvalitet for hver chatbot, spørgsmål for spørgsmål.
Hvor I vinder, og hvor I ikke gør
Resultaterne viser præcist, hvilke emner jeres chatbot håndterer bedre, og hvor en konkurrent giver stærkere svar.
Samarbejd med TestDevLab
Automatiseret i stor skala, kontrolleret af eksperter
»Det er ikke realistisk at score tusindvis af chatbotsvar i hånden, og det er det heller ikke at stole på, at én AI-model bedømmer en anden uden kontrol. Vi automatiserer kørslerne og scoringen og lader derefter QA-ingeniører gennemgå resultaterne, så I får både skala og dømmekraft i samme rapport. I har brug for begge dele for at vide, hvordan jeres chatbot faktisk svarer.«

Direktør for R&D og testautomatisering
- 500+
- erfarne QA-eksperter
- 5000+
- rigtige enheder
- 14
- år i QA-branchen
- 95,6 %
- kundefastholdelse
Resultatet
Scorer, I kan handle på
I får resultaterne og svarene bag dem, så jeres team kan se præcist, hvad der skal rettes.
I rapporten
- Scorer pr. metrik, emne, sprog og release
- Svartider, hvor de langsomste spørgsmål er markeret
- Hver hallucination og hvert sikkerhedsproblem med det spørgsmål, der udløste det
- Resultater side om side, hvis en konkurrent blev testet
- Hvad der skal rettes først
I datapakken
- Hele spørgsmålssættet og de korrekte svar
- Hvert råsvar, gemt, så resultaterne kan scores igen senere uden at køre testene på ny
- Den testede model- og chatbotversion med tidsstempel, så resultaterne kan sammenlignes med fremtidige kørsler
Se, hvordan resultaterne ser ud
Få en eksempelrapport fra en tidligere chatbotevaluering. Bed om en eksempelrapport.
Det grundlæggende
Hvad er test af AI-chatbots?
Test af AI-chatbots, også kaldet chatbotevaluering eller chatbot-QA, undersøger, hvor godt en chatbot besvarer rigtige brugerspørgsmål. Den måler performance, f.eks. svartid og konsistens, og svarkvalitet, f.eks. nøjagtighed, relevans, fuldstændighed, og om chatbotten opfinder oplysninger.
Test af AI-chatbots er en del af vores AI-testservices.
Sammenlignet med LLM-evaluering
LLM-evaluering scorer en model på et testdatasæt, typisk før den bygges ind i et produkt. Chatbot-test undersøger den færdige chatbot, sådan som jeres brugere møder den, med jeres indhold, jeres instruktioner og jeres brugerflade.
Sammenlignet med benchmarking af AI-agenter
En chatbot besvarer spørgsmål. En AI-agent udfører også handlinger i forretningsværktøjer, f.eks. at opdatere poster eller udstede refusioner. For agenter, se benchmarking af AI-agenter.
Se, hvordan jeres AI-chatbot scorer
Fortæl os, hvad jeres chatbot gør, og hvordan brugerne når den. Vi foreslår et spørgsmålssæt og de metrikker, der betyder noget, og viser jer, hvordan jeres første testrunde kommer til at se ud.
FAQ
Svar på de mest stillede spørgsmål
Chatbot-test undersøger, hvor hurtigt og hvor godt en chatbot besvarer rigtige brugerspørgsmål, fra svartid og konsistens til nøjagtighed og hallucinationer.
Vi opbygger et sæt forventede spørgsmål, uventede spørgsmål og længere samtaler ud fra, hvordan jeres brugere faktisk taler med den. Spørgsmålene sendes automatisk, svartiderne måles, og hvert svar scores på en skala fra 1 til 5 af AI-modeller, mens QA-ingeniører kontrollerer resultaterne.
For performance: første svartid, svargenereringstid, samlet svartid, ord pr. minut og konsistens. For svarkvalitet: en samlet kvalitetsscore samt nøjagtighed, relevans, fuldstændighed, hallucinationer og konteksthukommelse. For sikkerhed og tryghed: modstandsdygtighed over for prompt injection, datalækage, emneafgrænsning og skadeligt indhold. Det endelige sæt aftaler vi med jer.
Ja. Vi evaluerer svarkvaliteten på hvert sprog, jeres chatbot understøtter, også for brugere, der skriver på et sprog, som ikke er deres modersmål.
Ja. For chatbots, der svarer ud fra jeres egne dokumenter med retrieval-augmented generation (RAG), tjekker vi, om svarene understøttes af dokumenterne, og markerer alt, hvad chatbotten selv lægger til.
LLM-as-a-judge er en metode, hvor én stor sprogmodel scorer en anden models svar ud fra nedskrevne kriterier. Vi bruger modeller fra flere leverandører og lader QA-ingeniører gennemgå resultaterne, så scorerne forbliver pålidelige.
Vi sammenligner hvert svar med de oplysninger, chatbotten har lov til at bruge. Ethvert faktum, enhver politik eller kilde, som ikke understøttes af disse oplysninger, markeres som en hallucination.
Ja. Vi kører LLM red teaming-prompts, der forsøger at få chatbotten til at ignorere sine instruktioner, afsløre data eller producere skadeligt indhold, og rapporterer, hvor den holder stand, og hvor den ikke gør.
Ja. Begge chatbots får de samme spørgsmål under samme betingelser, og I får scorer side om side for hastighed, konsistens og svarkvalitet. Hvis I skal vælge mellem leverandører, kører vi samme sammenligning på de chatbots, I overvejer.
Før lancering og derefter efter hver væsentlig opdatering af jeres chatbot, dens indhold eller den AI-model, den kører på. Mange teams kører også et fast tjek, f.eks. månedligt, fordi eksterne modelopdateringer kan ændre svarene, uden at der er ændret noget hos jer.
Adgang til jeres chatbot, en beskrivelse af, hvad den er beregnet til, og de dokumenter eller data, den bruger til at svare. Vi opbygger spørgsmålene, kører testene og scorer resultaterne.