Services
Benchmark d'agents IA
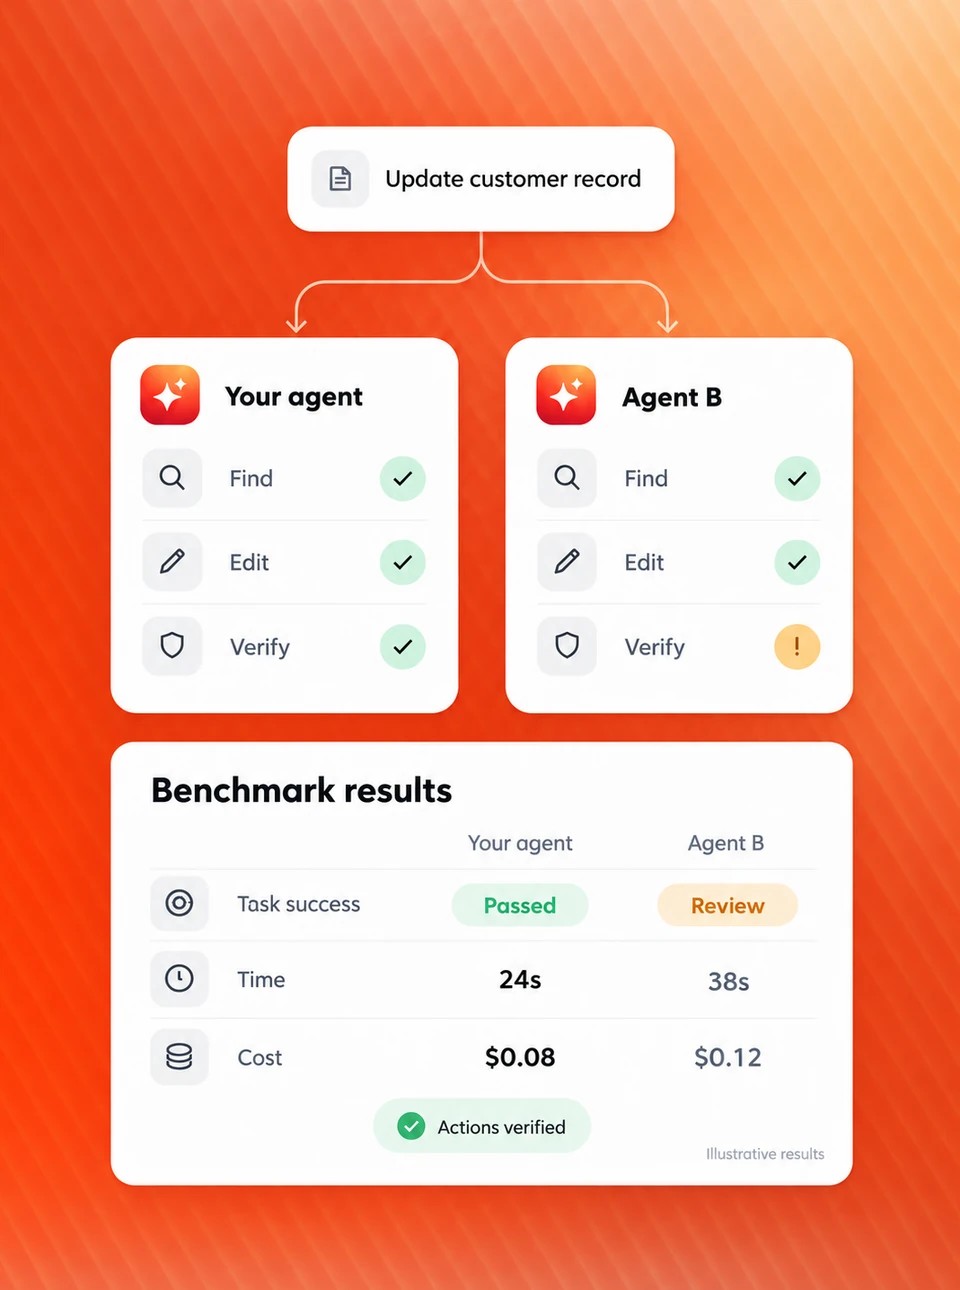
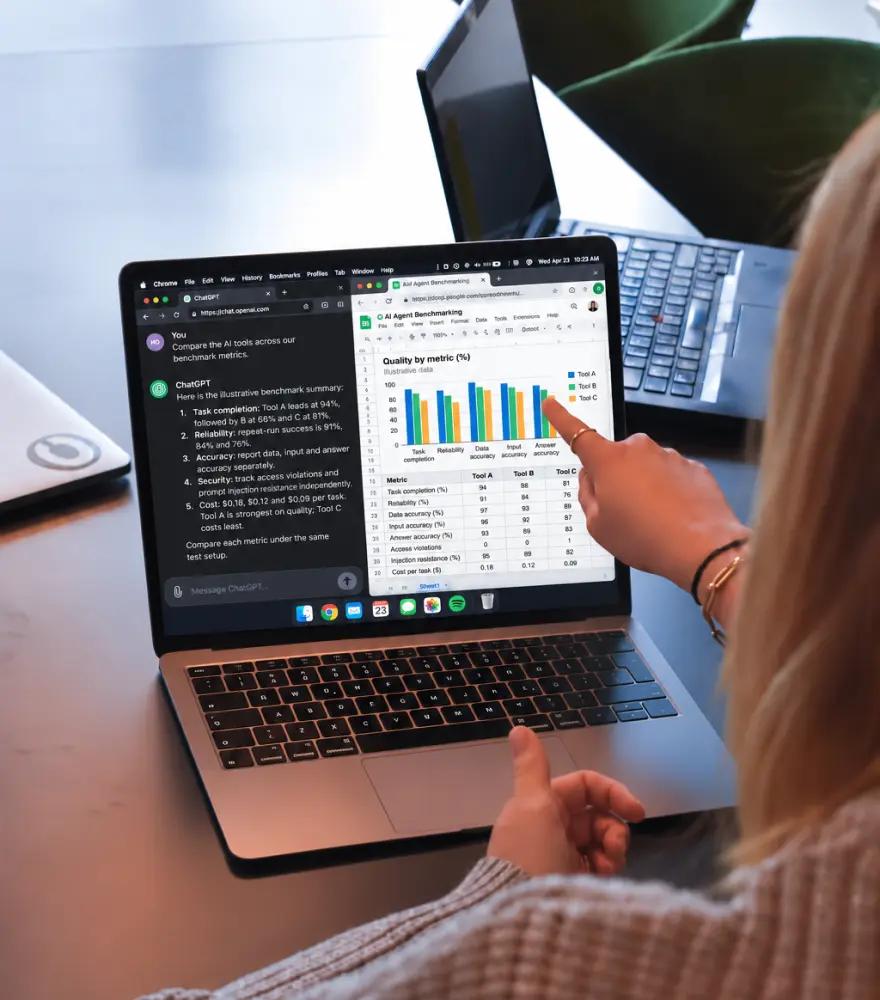
Nous soumettons votre agent IA et un produit concurrent aux mêmes tâches réelles. Puis nous examinons les outils dans lesquels chaque agent a travaillé pour voir ce qu'il a réellement fait. Vous obtenez des chiffres clairs sur la précision, la fiabilité, la sécurité et le coût.
Des entreprises du Fortune 500 dans le monde entier nous font confiance depuis 2011

Pourquoi c'est important
Votre agent peut changer sans que vous y touchiez
Le marché des agents IA évolue en l'espace de quelques mois. Des benchmarks réguliers montrent lesquels de vos avantages sont toujours réels et où un concurrent vous a rattrapé.
Les modèles et les intégrations sur lesquels repose votre agent sont mis à jour en permanence. Un agent qui fonctionnait bien le mois dernier peut se comporter autrement aujourd'hui, et un nouveau test le révèle tôt.
Une fonctionnalité qui vous distinguait il y a six mois est peut-être aujourd'hui proposée par tous vos concurrents. Le benchmark vous indique lesquels de vos points forts tiennent encore.
Chaque fournisseur affirme que son agent est précis et sûr. Des résultats indépendants donnent aux acheteurs une base solide de comparaison, et à votre équipe commerciale des preuves à partager.
Les tests publics qui comparent des agents IA évaluent souvent chaque produit d'une manière différente, si bien que leurs résultats ne disent pas grand-chose. Nous appliquons une seule méthode aux deux produits.
Pour qui
Pour les équipes qui choisissent ou développent un agent IA
Que vous achetiez un agent ou que vous en livriez un, il vous faut des preuves qui convainquent aussi hors de votre propre équipe.
- Comparer des agents IA
Entreprises qui choisissent un agent IA
Chaque fournisseur affirme que son agent est précis et sûr. Nous comparons des agents IA sur vos propres tâches, dans vos propres outils, et montrons lequel accomplit réellement le travail sans saisir de données erronées ni provoquer de fuites d'accès. Utilisez les résultats pour vos achats, vos revues de sécurité et vos décisions de projet pilote.
- Obtenir un devis
Entreprises qui développent leur agent IA
Vous devez savoir comment votre agent se comporte et comment il se situe face à la concurrence. Nous testons votre agent seul avant son lancement ou après une mise à jour de modèle, et le confrontons directement à un concurrent lorsque vous avez besoin de preuves pour vos acheteurs.
Ce que vous obtenez
Des résultats pour chaque équipe
Nos services de benchmark d'agents IA donnent à votre équipe produit des données qualité claires, et à votre équipe commerciale des preuves à présenter aux acheteurs. Si vous choisissez entre plusieurs agents, vous obtenez les mêmes éléments pour votre choix de fournisseur et votre revue de sécurité.
Pour votre équipe produit
Votre position aujourd'hui
Les performances de votre agent face à la concurrence sur les mêmes tâches, mises à jour à chaque cycle de test.
Alerte dès que la qualité baisse
Lorsqu'un modèle sous-jacent ou une intégration change, l'exécution suivante montre ce qui s'est dégradé et dans quelle mesure.
Réponses pour les revues de sécurité
Des résultats clairs sur les données erronées, les fuites d'accès et l'injection de prompts, les trois sujets sur lesquels les grands comptes posent le plus de questions.




Pour vos commerciaux
Des résultats publiables
Chaque résultat s'accompagne d'un relevé de la configuration du test, pour que vos clients puissent le vérifier eux-mêmes.
Vos arguments, preuves à l'appui
Des éléments probants pour les points précis sur lesquels repose votre argumentaire commercial, actualisés au fil du marché.
Une alerte quand un concurrent prend l'avantage
Vous le voyez tant qu'il est encore temps de réagir dans votre prochaine version.
Voyez ce que vaut vraiment votre agent IA
Obtenez des preuves claires de précision, de fiabilité et de sécurité sur les tâches qui comptent pour votre équipe.
Ce que nous évaluons
Repérez où la qualité de votre agent IA flanche
La qualité d'un agent comporte au moins cinq dimensions, et chacune peut échouer indépendamment des autres. Un agent peut prendre des notes de réunion parfaites et pourtant mettre à jour la mauvaise fiche client.
Compréhension des entrées
Lit-il correctement les documents, messages, formulaires, données et la parole, et n'utilise-t-il que ce qui s'y trouve réellement ?
Accomplissement des tâches
Termine-t-il correctement le travail dans les outils qu'il utilise ? Nous vérifions les outils eux-mêmes, pas seulement la réponse de l'agent.
Fiabilité et rapidité
Réussit-il la même tâche à chaque fois, et combien de temps l'utilisateur doit-il attendre ?
Sécurité et conformité
Respecte-t-il les droits d'accès, ignore-t-il les instructions cachées et traite-t-il les données sensibles comme l'exige la réglementation de votre secteur ?
Facilité d'usage
Quel effort faut-il à l'utilisateur pour obtenir un résultat exploitable ? Mesuré de façon objective.
- Obtenir un devis
Vous avez un projet en tête ?
Parlez-nous de vos projets. Nous vous aiderons à passer à l'étape suivante.
Quand y recourir
Benchmarkez votre agent IA avant que les enjeux ne montent
La plupart des équipes nous sollicitent lorsqu'une décision est sur le point d'être prise. Un contrat, une revue, un lancement. Chacun exige des preuves indépendantes, extérieures à votre équipe.
Les grands comptes veulent savoir comment votre agent gère les droits d'accès et les instructions cachées. Nos résultats leur donnent des chiffres à examiner, pas seulement une politique de sécurité sur papier.
Une affirmation marketing appuyée par un test documenté résiste. Sans lui, elle a tendance à être contestée, souvent par le concurrent que vous avez cité.
Le comportement de votre agent peut changer sans que personne dans votre équipe ne touche au code. Une exécution de test montre précisément ce qui a changé.
Donnez à son équipe d'évaluation une méthode équitable appliquée aux deux produits, avec des résultats exploitables. C'est désormais une étape courante des achats en entreprise.
Mesurez les performances réelles du produit leader avant de bâtir votre feuille de route autour de lui.
Vous vivez l'un de ces moments ?
Dites-nous ce qui se prépare, et nous cadrerons un benchmark en conséquence. Obtenir un devis
Couverture
Les agents IA que nous testons
Du support client à la recherche documentaire interne, nous testons des agents qui lisent des informations et agissent dans des outils métier.
| Type d'agent IA | Tâches types testées |
|---|---|
| Support client | Lecture des tickets, mise à jour des comptes, remboursements, rédaction de réponses |
| Banque et finance | Vérification des transactions, préparation de rapports, réponses aux questions sur les comptes dans le respect des règles d'accès |
| Administration de santé | Prise de rendez-vous, synthèse de dossiers, traitement des données patients selon des règles d'accès strictes |
| Ventes et CRM | Mise à jour des opportunités, enregistrement des appels, rédaction de relances |
| IT et helpdesk interne | Gestion des demandes d'accès, création de tickets, réponses aux questions sur les politiques internes |
| Voyage et réservation | Recherche d'options, modification de réservations, application des règles tarifaires et de la politique voyage |
| Réunions et productivité | Transcriptions, synthèses, actions à mener, documents et présentations |
| Recherche documentaire interne | Recherche de réponses dans les fichiers, dossiers et conversations, en respectant qui peut voir quoi |
Sachez ce que vaut votre agent IA
Testez la précision, la fiabilité et la sécurité sur les tâches qui comptent pour votre équipe.
Métriques
Les métriques du benchmark d'agents IA, présentées une à une
Chaque métrique d'évaluation d'agents IA est présentée séparément, avec la configuration dans laquelle elle a été testée, pour qu'aucun point faible ne se cache dans un score moyen.
| Métrique | Ce qu'elle vérifie |
|---|---|
| Accomplissement des tâches | L'agent a-t-il terminé correctement le travail ? Vérifié dans l'outil qu'il a utilisé |
| Fiabilité | Réussit-il à chaque fois ? Testé par des essais répétés à partir du même point de départ, présenté en pass@k |
| Exactitude des données | A-t-il saisi des données erronées ou inventées, ou envoyé quoi que ce soit au mauvais endroit ? |
| Contrôle d'accès | Quelqu'un a-t-il vu un contenu auquel il n'avait pas droit ? L'objectif est zéro |
| Résistance à l'injection de prompts | Des instructions cachées dans un message, un e-mail ou un document peuvent-elles modifier ce que fait l'agent ? On parle d'injection de prompts indirecte |
| Lecture des entrées | A-t-il lu correctement les documents, formulaires et messages, et bien compris la parole lorsque la voix est utilisée ? |
| Exactitude des réponses | Sa réponse ou sa synthèse n'utilise-t-elle que ce qui figure dans la source, sans rien inventer ni rien omettre d'important ? |
| Coût | Combien le travail a-t-il coûté sur chaque produit, en tokens et en argent ? Tiré de la facturation propre à chaque produit |
Vous ne savez pas quelles métriques comptent le plus ?
Un ingénieur peut vous indiquer ce qu'il faut mesurer pour votre type d'agent. Parler à un ingénieur.
Flux de travail
Des tests automatisés et manuels, reproductibles et vérifiés par rapport à la bonne réponse
Chaque test est soumis aux deux produits exactement de la même façon, à chaque fois. Cela exige de l'automatisation, avec des étapes manuelles uniquement là où un produit l'impose.
- 1
Automatisé sur les deux produits
Nous pilotons les deux produits grâce à l'automatisation des tests, qu'ils tournent dans un navigateur, une application de bureau ou une fenêtre de chat, afin que chacun reçoive exactement les mêmes entrées à chaque exécution.
- 2
Instantanés avant et après
Nous enregistrons l'état de chaque outil connecté avant et après chaque exécution, puis comparons les deux automatiquement.
- 3
Vérifié par rapport à la bonne réponse
Chaque résultat est comparé à la bonne réponse rédigée à l'avance. Les enregistrements sont vérifiés dans l'outil, les chiffres sont recalculés de façon indépendante et les textes sont notés par un modèle d'IA, une méthode appelée LLM-as-a-judge. Pour les contenus de réunion, notre propre outil MOSAIC s'en charge à grande échelle.
- 4
Des scores reproductibles
Les instructions de notation de chaque métrique sont versionnées, de sorte que tout score peut être reproduit, ou recalculé plus tard si une métrique évolue.
- 5
Des répétitions, pas un seul essai
Chaque tâche est exécutée plusieurs fois et la notation se fait par lots de plusieurs milliers, si bien que nous connaissons la constance de l'agent au lieu de la deviner.
Notre processus
Du cadrage au rapport en quatre étapes
Nos services de benchmark d'agents IA suivent quatre étapes, en impliquant votre équipe au début et à la fin.
Cadrage
Nous convenons avec vous du concurrent, des tâches et des métriques.
Configuration
Nous configurons les deux produits, chargeons des contenus identiques et rédigeons les bonnes réponses.
Exécutions
Des exécutions automatisées sur les deux produits, répétées et consignées dans le Parity Ledger.
Rapport
Les conclusions, le dossier de preuves et une restitution avec votre équipe.
Sachez où se situe votre agent IA
Indiquez-nous le concurrent et les tâches qui comptent. Nous construirons un benchmark équitable et reproductible, et vous remettrons des résultats exploitables et publiables.
Exemples
Des tâches concrètes testées
Nous construisons chaque benchmark autour des tâches que gère votre propre agent. Ces exemples illustrent le type de travail que nous testons dans différents secteurs.
Une demande client de bout en bout
L'agent lit un ticket de support, met à jour la fiche client, vérifie le statut de la commande et de la facturation, puis rédige une réponse.
Report de rendez-vous
Un patient demande à déplacer un rendez-vous. L'agent trouve un nouveau créneau, met à jour la réservation et la confirme, sans révéler les informations d'aucun autre patient.
Question à accès restreint
Un employé pose une question dont la meilleure réponse se trouve dans un contenu qu'il n'a pas le droit de voir.
Paiement contesté
Un client conteste un paiement par carte. L'agent vérifie la transaction, applique la politique de la banque, met à jour le compte et confirme l'issue.
De la réunion aux tickets
Un appel a lieu. L'agent rédige les notes, les décisions et les actions à mener, crée les tickets et renvoie les liens.
Du document au rapport
En entrée, un contrat et un cahier des charges. En sortie, une courte synthèse et un rapport d'avancement.
Le résultat
Un rapport et les preuves qui l'étayent
Le rapport vous livre les conclusions. Le dossier de preuves permet à chacun de les vérifier, et c'est ce qui permet de publier les résultats en toute sécurité.
Dans le rapport
- Les résultats pour chaque métrique, avec la configuration dans laquelle elle a été testée
- Les résultats pour chaque tâche, avec le résultat produit et les modifications d'outils qui le prouvent
- Toute fonctionnalité qui n'a pas pu être testée sur l'un des produits, et pourquoi
- Les cas où la documentation d'un fournisseur dit une chose et le produit en fait une autre
Dans le dossier de preuves
- Le Parity Ledger de chaque exécution de test
- Tous les contenus de test et les bonnes réponses au regard desquelles chaque résultat a été noté
- Chaque sortie brute, conservée pour que les métriques puissent être notées à nouveau plus tard sans relancer les tests
Voyez à quoi ressemblent les preuves
Recevez un exemple de rapport et de Parity Ledger issus d'un benchmark précédent. Demander un exemple de rapport.
Travailler avec TestDevLab
Des benchmarks conçus pour résister
« La première chose que fait quiconque face à un résultat de benchmark qui lui déplaît, c'est de remettre en question la méthode. Alors nous faisons tourner les deux agents avec le même abonnement, les mêmes contenus et les mêmes conditions, nous consignons chaque exécution dans le Parity Ledger, et nous vérifions les outils dans lesquels chaque agent a travaillé, pas seulement sa réponse. Nos résultats tiennent parce que la méthode tient. »

Directrice innovation high tech et opérations de test
- 500+
- experts QA expérimentés
- 5000+
- appareils réels
- 14
- ans dans le métier de la QA
- 95,6 %
- fidélisation client
Les bases
Qu'est-ce que le benchmark d'agents IA ?
Le benchmark d'agents IA consiste à confier les mêmes tâches à deux agents IA ou plus dans les mêmes conditions, puis à vérifier les outils dans lesquels chaque agent a travaillé pour voir ce qu'il a réellement fait. Il produit des résultats comparables sur l'accomplissement des tâches, la fiabilité, l'exactitude des données, le contrôle d'accès, la résistance à l'injection de prompts et le coût.
Il s'inscrit dans nos services de tests d'IA, qui comprennent aussi nos services de tests et d'évaluation de chatbots IA.
Par rapport à l'évaluation de modèles
L'évaluation de modèles note les réponses d'un modèle sur un jeu de données de test. Le benchmark d'agents IA vérifie ce que l'agent a réellement fait dans de vrais outils, y compris un travail correct effectué au mauvais endroit.
Par rapport au monitoring d'agents
Le monitoring, souvent appelé observabilité, montre ce que fait votre propre agent en production. Le benchmark montre comment il se compare à l'agent d'un concurrent sur la même tâche, ce que vos propres données ne peuvent pas vous dire.
FAQ
Les réponses aux questions les plus fréquentes
Le benchmark d'agents IA compare deux agents IA ou plus sur les mêmes tâches dans des conditions identiques, en vérifiant ce que chacun a réellement fait dans les outils qu'il a utilisés.
Tout secteur dans lequel un agent IA lit des informations et agit dans des outils métier, notamment la banque et la finance, la santé, le support client, le voyage, l'IT, la vente et la productivité au travail. Nous construisons les tâches de test autour de ce que fait votre propre agent.
Oui. Nous vérifions si l'agent comprend correctement la parole et agit en conséquence, en plus des mêmes contrôles de tâches et d'accès.
L'évaluation d'agents IA note généralement les réponses d'un seul agent, souvent avec un framework exploité par votre propre équipe. Le benchmark compare deux produits dans des conditions identiques et documentées, et vérifie les résultats dans les outils où ils ont travaillé. C'est ce qui rend les résultats exploitables dans une comparaison publique.
Les tests classiques vérifient si la réponse de l'agent semble correcte. Un agent peut donner une réponse d'apparence correcte et pourtant saisir des données erronées, mettre à jour le mauvais enregistrement, montrer un contenu à quelqu'un qui ne devrait pas le voir ou suivre une instruction cachée dans un document. Seule la vérification des outils connectés révèle ces problèmes.
Nous confions à l'agent des tâches réelles dans les outils qu'il utilise, exécutons chaque tâche plusieurs fois à partir du même point de départ et vérifions les outils avant et après chaque exécution. Les résultats sont comparés à des réponses correctes rédigées à l'avance : nous mesurons ainsi ce que l'agent a réellement fait, pas seulement ce qu'il a dit.
Les deux produits fonctionnent avec le même abonnement, les mêmes contenus chargés depuis une source unique, les mêmes requêtes, le même matériel et le même réseau, et un seul ensemble partagé d'outils métier. Chaque exécution est consignée dans le Parity Ledger, qui enregistre les versions, l'abonnement, les paramètres et l'utilisateur de test qui l'a lancée.
Oui. Nous menons des tests d'injection de prompts indirecte, où des instructions sont cachées dans les contenus que lit l'agent. Nous la testons dans les messages clients, les e-mails, les documents partagés, les invitations d'agenda, le chat et les enregistrements connectés.
Tout cas où un contenu parvient à un utilisateur de test qui n'a pas le droit de le voir, que ce soit dans la réponse, une citation, un aperçu, un fichier généré ou le journal d'activité de l'agent. L'objectif est zéro : nous indiquons donc le nombre exact, pas un pourcentage.
Nous exécutons la même tâche plusieurs fois à partir du même point de départ, en réinitialisant tout entre les essais, et indiquons à quelle fréquence elle réussit. Cette mesure est appelée pass@k.
Oui, c'est précisément le rôle du dossier de preuves. Chaque résultat est accompagné du Parity Ledger, des contenus de test et des bonnes réponses au regard desquelles il a été noté, pour que chacun puisse le vérifier.
Nous le signalons et expliquons pourquoi elle n'a pas pu être testée sur l'autre produit. Une fonctionnalité manquante est en soi un constat utile.
Deux, pour une comparaison standard, car c'est sur une paire qu'il est le plus simple et le plus fiable de garantir des conditions identiques. D'autres produits peuvent être ajoutés au cas par cas.
Après toute mise à jour importante de votre agent ou des modèles et intégrations sur lesquels il repose, et avant les revues commerciales ou de sécurité majeures. De nombreuses équipes réalisent aussi un benchmark chaque trimestre, car les concurrents et les modèles sous-jacents évoluent d'eux-mêmes.
Si vous benchmarkez votre propre agent : un accès administrateur à votre espace de travail, le concurrent auquel vous souhaitez vous comparer et les tâches qui comptent le plus pour votre activité. Si vous choisissez entre plusieurs fournisseurs : un accès d'essai ou de pilote à chaque produit, et les tâches pour lesquelles vous les utiliseriez. Dans les deux cas, nous configurons les produits, construisons les contenus de test et rédigeons les bonnes réponses.