Pakalpojumi
AI aģentu salīdzinošā novērtēšana
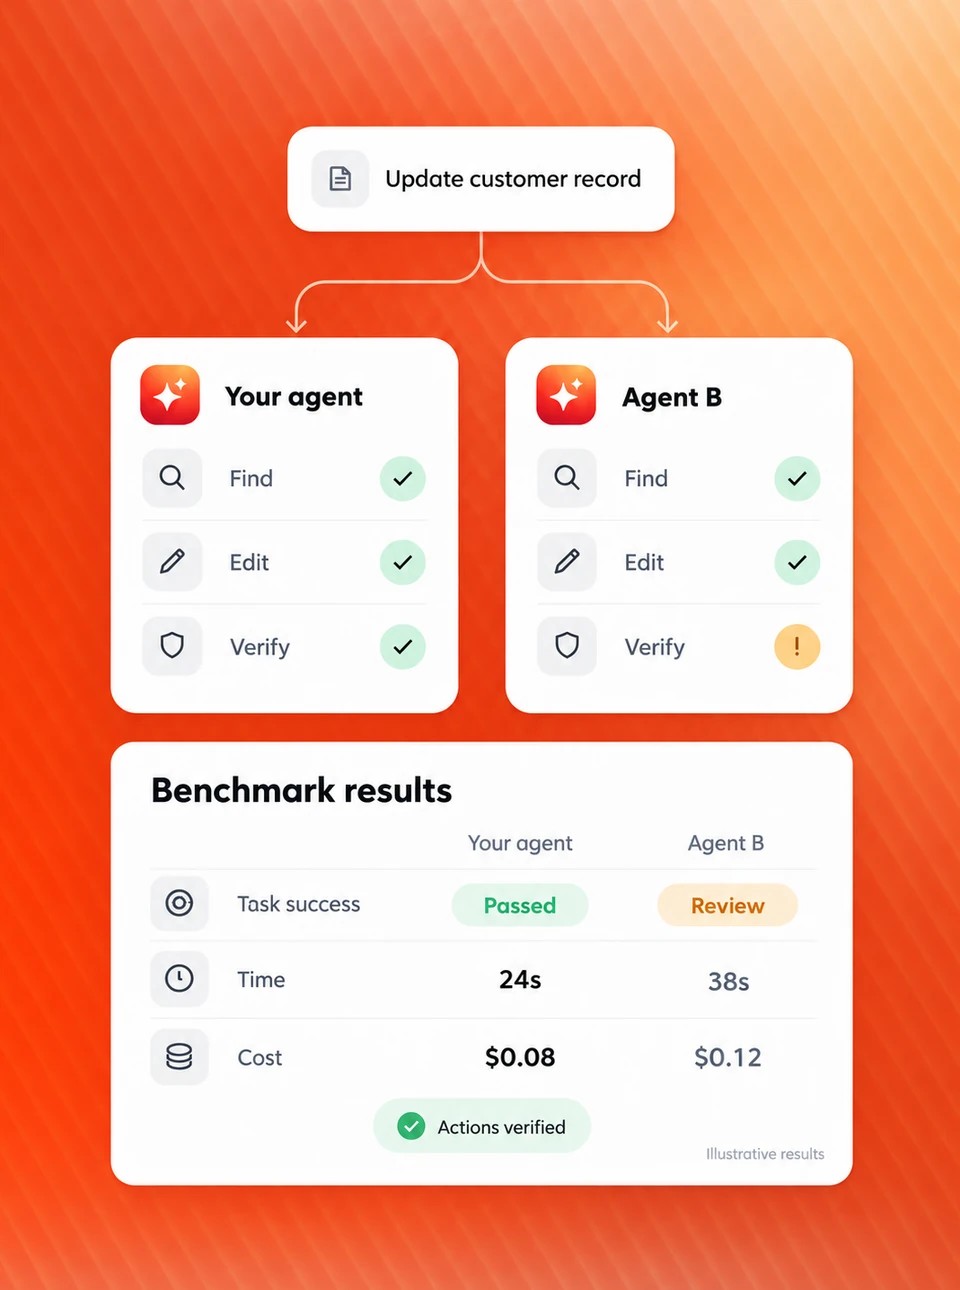
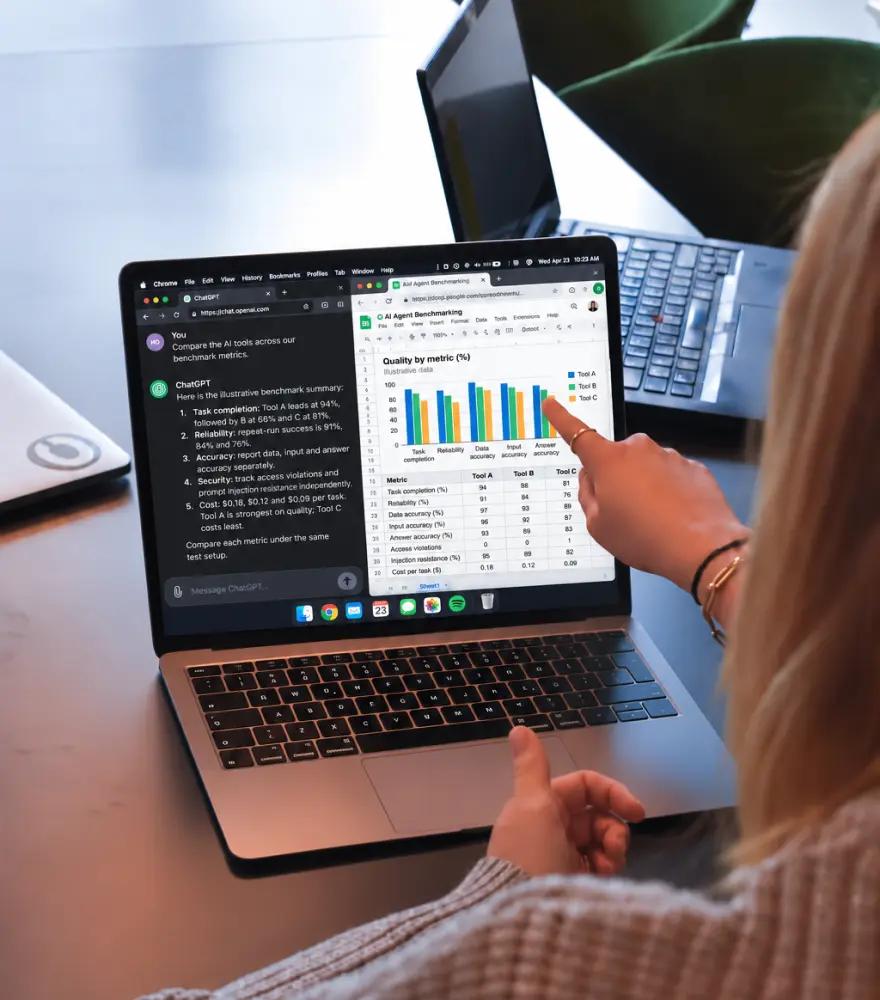
Mēs Jūsu mākslīgā intelekta (AI) aģentu un konkurējošu produktu darbinām ar vieniem un tiem pašiem reāliem darba uzdevumiem. Pēc tam ieskatāmies rīkos, kuros katrs aģents strādāja, lai redzētu, ko tas patiesībā izdarīja. Jūs saņemat skaidrus skaitļus par precizitāti, uzticamību, drošību un izmaksām.
Fortune 500 uzņēmumi visā pasaulē uzticas mums kopš 2011. gada

Kāpēc tas ir svarīgi
Jūsu aģents var mainīties arī bez Jūsu iejaukšanās
AI aģentu tirgus mainās ik pēc dažiem mēnešiem. Regulāra salīdzinošā novērtēšana parāda, kuras no Jūsu priekšrocībām joprojām ir reālas un kur konkurents Jūs ir panācis.
Modeļi un integrācijas, uz kurām balstās Jūsu aģents, tiek atjaunināti nepārtraukti. Aģents, kas pagājušajā mēnesī strādāja labi, šodien var uzvesties citādi, un atkārtots tests to atklāj laikus.
Funkcija, kas pirms sešiem mēnešiem Jūs izcēla, tagad var būt ikviena konkurenta piedāvājumā. Salīdzinošā novērtēšana parāda, kuras no Jūsu stiprajām pusēm joprojām ir spēkā.
Katrs piegādātājs apgalvo, ka viņa aģents ir precīzs un drošs. Neatkarīgi rezultāti dod pircējiem kaut ko konkrētu, ar ko salīdzināt, bet Jūsu pārdošanas komandai — pierādījumus, ar kuriem dalīties.
Publiskos testos, kuros salīdzina AI aģentus, katru produktu bieži pārbauda citādi, tāpēc rezultāti pasaka ļoti maz. Mēs abiem produktiem izmantojam vienu metodi.
Kam tas paredzēts
Komandām, kas izvēlas AI aģentu, un komandām, kas to veido
Neatkarīgi no tā, vai aģentu pērkat vai paši to izlaižat, Jums vajadzīgi pierādījumi, kas iztur pārbaudi arī ārpus Jūsu komandas.
- Salīdzināt AI aģentus
Uzņēmumiem, kas izvēlas starp AI aģentiem
Katrs piegādātājs apgalvo, ka viņa aģents ir precīzs un drošs. Mēs salīdzinām AI aģentus Jūsu pašu uzdevumos un Jūsu pašu rīkos un parādām, kurš no tiem patiešām paveic darbu, neievadot nepareizus datus un nenopludinot piekļuvi. Izmantojiet rezultātus iepirkumos, drošības pārskatos un lēmumos par pilotprojektiem.
- Pieprasīt tāmi
Uzņēmumiem, kas izstrādā savu AI aģentu
Jums jāzina, kā darbojas Jūsu aģents un kā tas izskatās līdzās konkurentiem. Mēs testējam Jūsu aģentu atsevišķi pirms palaišanas vai pēc modeļa atjauninājuma un salīdzinām to tiešā sacensībā ar konkurentu, kad Jums vajadzīgi pierādījumi pircējiem.
Ko Jūs iegūstat
Rezultāti, ko var izmantot ikviena komanda
Mūsu AI aģentu salīdzinošās novērtēšanas pakalpojumi sniedz Jūsu produkta komandai skaidrus kvalitātes datus, bet pārdošanas komandai — pierādījumus, ko parādīt pircējiem. Ja izvēlaties starp aģentiem, Jūs saņemat tos pašus pierādījumus lēmumam par piegādātāju un drošības pārskatam.
Jūsu produkta komandai
Kur Jūs esat šodien
Jūsu aģenta sniegums salīdzinājumā ar konkurentiem tajos pašos uzdevumos, atjaunināts ar katru testēšanas ciklu.
Agrs brīdinājums, kad kvalitāte krītas
Kad mainās pamatā esošais modelis vai integrācija, nākamā izpilde parāda, kas pasliktinājās un cik daudz.
Atbildes drošības pārskatiem
Skaidri rezultāti par nepareiziem datiem, piekļuves noplūdēm un uzvedņu injekcijām — trim lietām, par ko uzņēmumu pircēji jautā visbiežāk.




Jūsu pārdošanas komandai
Rezultāti, ko varat publicēt
Katram rezultātam pievienots pieraksts par to, kā tests tika iestatīts, lai klienti to varētu pārbaudīt paši.
Pierādījumi Jūsu apgalvojumiem
Pierādījumi tieši tiem punktiem, uz kuriem balstās Jūsu pārdošanas piedāvājums, atjaunoti līdz ar tirgus izmaiņām.
Brīdinājums, kad konkurents izvirzās vadībā
Jūs to redzat, kamēr vēl ir laiks reaģēt nākamajā izlaidumā.
Uzziniet, kā Jūsu AI aģents darbojas patiesībā
Saņemiet skaidrus pierādījumus par precizitāti, uzticamību un drošību uzdevumos, kas Jūsu komandai ir svarīgi.
Ko mēs vērtējam
Atrodiet, kur Jūsu AI aģenta kvalitāte klibo
Aģenta kvalitātei ir vismaz piecas daļas, un katra no tām var neizdoties atsevišķi. Aģents var nevainojami pierakstīt sapulces piezīmes un tomēr atjaunināt nepareiza klienta ierakstu.
Ievades izpratne
Vai tas pareizi nolasa dokumentus, ziņas, veidlapas, datus un runu un izmanto tikai to, kas tur patiešām ir?
Uzdevumu izpilde
Vai tas pareizi paveic darbu rīkos, kuros strādā? Mēs pārbaudām pašus rīkus, ne tikai aģenta atbildi.
Uzticamība un ātrums
Vai tas katru reizi pareizi izpilda vienu un to pašu uzdevumu, un cik ilgi lietotājam jāgaida?
Drošība un atbilstība
Vai tas ievēro piekļuves tiesības, ignorē slēptus norādījumus un apstrādā sensitīvus datus tā, kā to prasa Jūsu nozares noteikumi?
Lietošanas ērtums
Cik daudz pūļu lietotājam jāiegulda, lai iegūtu izmantojamu rezultātu? Mērīts objektīvi.
- Pieprasīt tāmi
Plānojat projektu?
Pastāstiet, ko plānojat. Mēs palīdzēsim spert nākamo soli.
Kad tas nepieciešams
Salīdziniet savu AI aģentu, pirms riski pieaug
Vairums komandu vēršas pie mums, kad drīz kaut kas tiks izlemts. Darījums, pārskats, palaišana. Katrā no šiem brīžiem vajadzīgi neatkarīgi pierādījumi no kāda ārpus Jūsu komandas.
Uzņēmumu pircēji vēlas zināt, kā Jūsu aģents rīkojas ar piekļuves tiesībām un slēptiem norādījumiem. Mūsu rezultāti dod viņiem skaitļus, ko izvērtēt, nevis tikai politikas dokumentu.
Mārketinga apgalvojums, ko pamato dokumentēts tests, iztur pārbaudi. Apgalvojumu bez tāda bieži apstrīd, nereti tieši Jūsu nosauktais konkurents.
Jūsu aģenta uzvedība var mainīties, pat ja neviens Jūsu komandā nav pieskāries kodam. Testa izpilde parāda, kas tieši mainījās.
Dodiet viņu novērtēšanas komandai vienu godīgu metodi, ko piemēro abiem produktiem, un rezultātus, uz kuru pamata var rīkoties. Uzņēmumu iepirkumos tas tagad ir ierasts solis.
Uzziniet, cik labi vadošais produkts patiesībā darbojas, pirms veidojat savu ceļa karti, balstoties uz to.
Jūs sagaida kāds no šiem brīžiem?
Pastāstiet, kas Jūs sagaida, un mēs izstrādāsim salīdzinošo novērtēšanu tieši tam. Pieprasīt tāmi
Pārklājums
AI aģenti, kurus novērtējam
No klientu atbalsta līdz uzņēmuma zināšanu meklēšanai — mēs testējam aģentus, kas lasa informāciju un veic darbības biznesa rīkos.
| AI aģenta veids | Tipiski testētie uzdevumi |
|---|---|
| Klientu atbalsts | Pieteikumu lasīšana, kontu atjaunināšana, atmaksu noformēšana, atbilžu sagatavošana |
| Banki un finanses | Darījumu pārbaude, pārskatu sagatavošana, atbildes uz jautājumiem par kontu piekļuves noteikumu robežās |
| Veselības aprūpes administrēšana | Vizīšu pierakstīšana, ierakstu kopsavilkumi, pacientu datu apstrāde saskaņā ar stingriem piekļuves noteikumiem |
| Pārdošana un CRM | Darījumu atjaunināšana, zvanu reģistrēšana, turpmāko ziņu sagatavošana |
| IT un iekšējais atbalsts | Piekļuves pieprasījumu pārvaldība, pieteikumu reģistrēšana, atbildes uz jautājumiem par politikām |
| Ceļojumi un rezervēšana | Iespēju meklēšana, rezervāciju maiņa, tarifu un uzņēmuma ceļošanas noteikumu piemērošana |
| Sapulces un produktivitāte | Atšifrējumi, kopsavilkumi, veicamie darbi, dokumenti un prezentācijas |
| Uzņēmuma zināšanu meklēšana | Atbilžu meklēšana failos, ierakstos un tērzēšanās, ievērojot, kurš ko drīkst redzēt |
Uzziniet, kā darbojas Jūsu AI aģents
Testējiet precizitāti, uzticamību un drošību uzdevumos, kas Jūsu komandai ir svarīgi.
Metrikas
AI aģentu salīdzinošās novērtēšanas metrikas, katra atsevišķi
Katra AI aģentu novērtēšanas metrika tiek atspoguļota atsevišķi, kopā ar iestatījumiem, kādos tā testēta, lai neviena vājā vieta nepazustu vidējā vērtējumā.
| Metrika | Ko tā pārbauda |
|---|---|
| Uzdevumu izpilde | Vai aģents darbu paveica pareizi? Pārbaudīts rīkā, kurā tas strādāja |
| Uzticamība | Vai tam izdodas katru reizi? Testēts ar atkārtotiem mēģinājumiem no viena un tā paša sākumstāvokļa, atspoguļots kā pass@k |
| Datu precizitāte | Vai tas ievadīja nepareizus vai izdomātus datus vai nosūtīja kaut ko uz nepareizu vietu? |
| Piekļuves kontrole | Vai kāds redzēja saturu, ko viņam nebija atļauts redzēt? Mērķis ir nulle |
| Noturība pret uzvedņu injekcijām | Vai ziņā, e-pastā vai dokumentā paslēpti norādījumi var mainīt to, ko aģents dara? To sauc par netiešo uzvedņu injekciju |
| Ievades precizitāte | Vai tas pareizi nolasīja dokumentus, veidlapas un ziņas un, ja tiek izmantota balss, pareizi sadzirdēja runu? |
| Atbilžu precizitāte | Vai tā atbilde vai kopsavilkums izmanto tikai avotā esošo, neko neizdomājot un neizlaižot neko svarīgu? |
| Izmaksas | Cik darbs izmaksāja katrā produktā — tokenos un naudā? Ņemts no katra produkta norēķinu datiem |
Neesat pārliecināti, kuras metrikas ir svarīgākās?
Inženieris var izstāstīt, ko mērīt Jūsu aģenta veidam. Sarunāties ar inženieri.
Darbplūsma
Automatizēta un manuāla testēšana, atkārtojama un salīdzināta ar pareizo atbildi
Katru testu abiem produktiem katru reizi padodam tieši vienādi. Tam vajadzīga automatizācija, un manuālie soļi — tikai tur, kur produkts to prasa.
- 1
Automatizēts abos produktos
Abus produktus vada testēšanas automatizācija neatkarīgi no tā, vai tie darbojas pārlūkā, darbvirsmas lietotnē vai tērzēšanas logā, tāpēc katrs katrā izpildē saņem tieši tādu pašu ievadi.
- 2
Momentuzņēmumi pirms un pēc
Mēs fiksējam katra pievienotā rīka stāvokli pirms un pēc katras izpildes un pēc tam automātiski salīdzinām abus.
- 3
Salīdzināts ar pareizo atbildi
Katru rezultātu salīdzina ar iepriekš uzrakstītu pareizo atbildi. Ierakstus pārbauda rīkā, skaitļus neatkarīgi pārrēķina, bet tekstu vērtē AI modelis — metode, ko sauc par LLM-as-a-judge. Sapulču saturam to lielā mērogā dara mūsu pašu rīks MOSAIC.
- 4
Atkārtojami vērtējumi
Katras metrikas vērtēšanas instrukcijām tiek veikta versiju kontrole, tāpēc jebkuru vērtējumu var atkārtot vai vēlāk pārrēķināt, ja metrika mainās.
- 5
Daudz atkārtojumu, nevis viena izpilde
Katrs uzdevums tiek izpildīts vairākas reizes, un vērtēšana notiek tūkstošu pakās, tāpēc mēs zinām, cik konsekvents ir aģents, nevis minam.
Mūsu process
No tvēruma līdz ziņojumam četros soļos
Mūsu AI aģentu salīdzinošās novērtēšanas pakalpojumi ietver četrus soļus, un Jūsu komanda ir iesaistīta sākumā un beigās.
Tvērums
Kopā ar Jums vienojamies par konkurentu, uzdevumiem un metrikām.
Iestatīšana
Mēs sagatavojam abus produktus, ielādējam identisku saturu un uzrakstām pareizās atbildes.
Izpildes
Automatizētas izpildes abos produktos, atkārtotas un reģistrētas Parity Ledger.
Ziņojums
Secinājumi, pierādījumu pakete un rezultātu izskatīšana kopā ar Jūsu komandu.
Uzziniet, kur stāv Jūsu AI aģents
Nosauciet konkurentu un svarīgākos uzdevumus. Mēs izveidosim godīgu, atkārtojamu salīdzinošo novērtēšanu un sniegsim rezultātus, uz kuru pamata varat rīkoties un kurus varat publicēt.
Piemēri
Reāli uzdevumi, kurus testējam
Katru salīdzinošo novērtēšanu veidojam ap uzdevumiem, ko veic Jūsu aģents. Šie piemēri parāda, kāda veida darbu testējam dažādās nozarēs.
Klienta pieprasījums no sākuma līdz beigām
Aģents izlasa atbalsta pieteikumu, atjaunina klienta ierakstu, pārbauda pasūtījuma un norēķinu statusu un sagatavo atbildi.
Vizītes maiņa
Pacients lūdz pārcelt vizīti. Aģents atrod jaunu laiku, atjaunina rezervāciju un to apstiprina, neatklājot neviena cita pacienta datus.
Jautājums ar ierobežotu piekļuvi
Darbinieks jautā kaut ko, uz ko labākā atbilde atrodas saturā, ko viņam nav atļauts redzēt.
Maksājuma apstrīdēšana
Klients apstrīd maksājumu ar karti. Aģents pārbauda darījumu, piemēro bankas politiku, atjaunina kontu un apstiprina iznākumu.
No sapulces līdz pieteikumiem
Notiek zvans. Aģents pieraksta piezīmes, lēmumus un veicamos darbus, izveido pieteikumus un atgriež saites.
No dokumenta līdz ziņojumam
Ievadē — līgums un projekta specifikācija. Izvadē — īss kopsavilkums un statusa ziņojums.
Rezultāts
Ziņojums un pierādījumi, kas to pamato
Ziņojums sniedz secinājumus. Pierādījumu pakete ļauj ikvienam tos pārbaudīt, un tieši tas padara rezultātus droši publicējamus.
Ziņojumā
- Rezultāti katrai metrikai ar iestatījumiem, kādos tā testēta
- Rezultāti katram uzdevumam ar izvadi un rīku izmaiņām, kas to pierāda
- Jebkura funkcija, ko vienā no produktiem nevarēja notestēt, un iemesls
- Vietas, kur piegādātāja dokumentācijā teikts viens, bet produkts dara ko citu
Pierādījumu paketē
- Parity Ledger katrai testa izpildei
- Viss testa saturs un pareizās atbildes, ar kurām salīdzināts katrs rezultāts
- Katra neapstrādātā izvade, saglabāta, lai metrikas vēlāk varētu pārvērtēt, testus neizpildot atkārtoti
Apskatiet, kā izskatās pierādījumi
Saņemiet ziņojuma paraugu un Parity Ledger no kādas iepriekšējās salīdzinošās novērtēšanas. Pieprasīt ziņojuma paraugu.
Sadarbojieties ar TestDevLab
Novērtējumi, kas iztur pārbaudi
„Pirmais, ko ikviens dara ar salīdzinošās novērtēšanas rezultātu, kas viņam nepatīk, ir apšaubīt metodi. Tāpēc mēs abus aģentus darbinām ar vienu un to pašu plānu, vienu un to pašu saturu un vienādos apstākļos, katru izpildi reģistrējam Parity Ledger un pārbaudām rīkus, kuros katrs aģents strādāja, ne tikai tā atbildi. Mūsu rezultāti iztur pārbaudi, jo to iztur metode.”

High tech inovāciju un testēšanas operāciju direktore
- 500+
- pieredzējuši QA eksperti
- 5000+
- reālas ierīces
- 14
- gadi QA nozarē
- 95,6 %
- klientu noturība
Pamati
Kas ir AI aģentu salīdzinošā novērtēšana?
AI aģentu salīdzinošā novērtēšana nozīmē, ka diviem vai vairākiem AI aģentiem dod vienus un tos pašus uzdevumus vienādos apstākļos un pēc tam pārbauda rīkus, kuros katrs aģents strādāja, lai redzētu, ko tas patiesībā izdarīja. Tā sniedz salīdzināmus rezultātus par uzdevumu izpildi, uzticamību, datu precizitāti, piekļuves kontroli, noturību pret uzvedņu injekcijām un izmaksām.
Tā ir daļa no mūsu plašākajiem AI testēšanas pakalpojumiem, tostarp AI čatbotu testēšanas un novērtēšanas pakalpojumiem.
Salīdzinājumā ar modeļu novērtēšanu
Modeļu novērtēšanā modeļa atbildes salīdzina ar testa datu kopu. AI aģentu salīdzinošā novērtēšana pārbauda, ko aģents patiesībā izdarīja reālos rīkos, tostarp pareizu darbu, kas paveikts nepareizā vietā.
Salīdzinājumā ar aģentu monitoringu
Monitorings, ko bieži dēvē par novērojamību (observability), parāda, ko Jūsu aģents dara produkcijā. Salīdzinošā novērtēšana parāda, kā tas izskatās salīdzinājumā ar konkurenta aģentu tajā pašā uzdevumā — to Jūsu pašu dati nevar pateikt.
FAQ
Atbildes uz biežāk uzdotajiem jautājumiem
AI aģentu salīdzinošā novērtēšana salīdzina divus vai vairākus AI aģentus vienos un tajos pašos uzdevumos identiskos apstākļos, pārbaudot, ko katrs no tiem patiesībā izdarīja izmantotajos rīkos.
Jebkurai nozarei, kurā AI aģents lasa informāciju un veic darbības biznesa rīkos, tostarp banku un finanšu nozarei, veselības aprūpei, klientu atbalstam, ceļojumiem, IT, pārdošanai un darba produktivitātei. Testa uzdevumus veidojam ap to, ko dara Jūsu aģents.
Jā. Mēs pārbaudām, vai aģents pareizi sadzird runu un atbilstoši rīkojas, līdztekus tām pašām uzdevumu un piekļuves pārbaudēm.
AI aģentu novērtēšana parasti vērtē viena aģenta atbildes, bieži ar ietvaru, ko darbina Jūsu pašu komanda. Salīdzinošā novērtēšana salīdzina divus produktus identiskos, dokumentētos apstākļos un pārbauda rezultātus rīkos, kuros tie strādāja. Tieši tas padara rezultātus izmantojamus publiskā salīdzinājumā.
Standarta testi pārbauda, vai aģenta atbilde izskatās pareiza. Aģents var sniegt atbildi, kas izskatās pareiza, un tomēr ievadīt nepareizus datus, atjaunināt nepareizu ierakstu, parādīt saturu kādam, kam to nevajadzētu redzēt, vai izpildīt dokumentā paslēptu norādījumu. Šādas problēmas atklāj, tikai pārbaudot pievienotos rīkus.
Mēs dodam aģentam reālus uzdevumus rīkos, kuros tas strādā, katru uzdevumu izpildām vairākas reizes no viena un tā paša sākumstāvokļa un pārbaudām rīkus pirms un pēc katras izpildes. Rezultātus salīdzinām ar iepriekš uzrakstītām pareizajām atbildēm, tāpēc mērām to, ko aģents patiesībā izdarīja, nevis tikai to, ko tas teica.
Abi produkti darbojas ar vienu un to pašu abonēšanas plānu, ar vienu un to pašu saturu, kas ielādēts no viena avota, ar vieniem un tiem pašiem pieprasījumiem, to pašu aparatūru un tīklu un vienu kopīgu biznesa rīku kopumu. Katra izpilde tiek reģistrēta Parity Ledger, kurā fiksētas versijas, plāns, iestatījumi un testa lietotājs, kurš to veica.
Jā. Mēs veicam uzvedņu injekciju testēšanu, pārbaudot netiešās uzvedņu injekcijas, kurās norādījumi ir paslēpti saturā, ko aģents lasa. Mēs to testējam klientu ziņās, e-pastos, koplietotos dokumentos, kalendāra ielūgumos, tērzēšanā un pievienotajos ierakstos.
Jebkurš gadījums, kad saturs nonāk pie testa lietotāja, kuram to nav atļauts redzēt, — vai tā būtu atbilde, citāts, priekšskatījums, ģenerēts fails vai aģenta darbību žurnāls. Mērķis ir nulle, tāpēc mēs norādām precīzu skaitu, nevis procentus.
Mēs izpildām vienu un to pašu uzdevumu vairākas reizes no viena un tā paša sākumstāvokļa, starp mēģinājumiem visu atiestatot, un norādām, cik bieži tas izdodas. Šo rādītāju sauc par pass@k.
Jā, tieši tam ir paredzēta pierādījumu pakete. Katram rezultātam pievienots Parity Ledger, testa saturs un pareizās atbildes, ar kurām tas salīdzināts, tāpēc ikviens to var pārbaudīt.
Mēs to norādām ziņojumā un paskaidrojam, kāpēc to nevarēja notestēt otrā produktā. Trūkstoša funkcija pati par sevi ir noderīgs secinājums.
Standarta salīdzinājums ir divi produkti, jo pārim visvieglāk un visuzticamāk nodrošināt identiskus apstākļus. Vairāk produktu var pievienot, izvērtējot katru gadījumu atsevišķi.
Pēc jebkura būtiska Jūsu aģenta vai tā izmantoto modeļu un integrāciju atjauninājuma, kā arī pirms nozīmīgiem pārdošanas vai drošības pārskatiem. Daudzas komandas salīdzinošo novērtēšanu veic arī reizi ceturksnī, jo konkurenti un pamatā esošie modeļi mainās paši no sevis.
Ja salīdzinoši novērtējat savu aģentu: administratora piekļuve Jūsu darbvietai, konkurents, ar kuru vēlaties salīdzināt, un uzdevumi, kas Jūsu uzņēmumam ir vissvarīgākie. Ja izvēlaties starp piegādātājiem: izmēģinājuma vai pilotprojekta piekļuve katram produktam un uzdevumi, kuriem tos izmantotu. Jebkurā gadījumā mēs sagatavojam produktus, izveidojam testa saturu un uzrakstām pareizās atbildes.