Tjänster
Benchmarking av AI-agenter
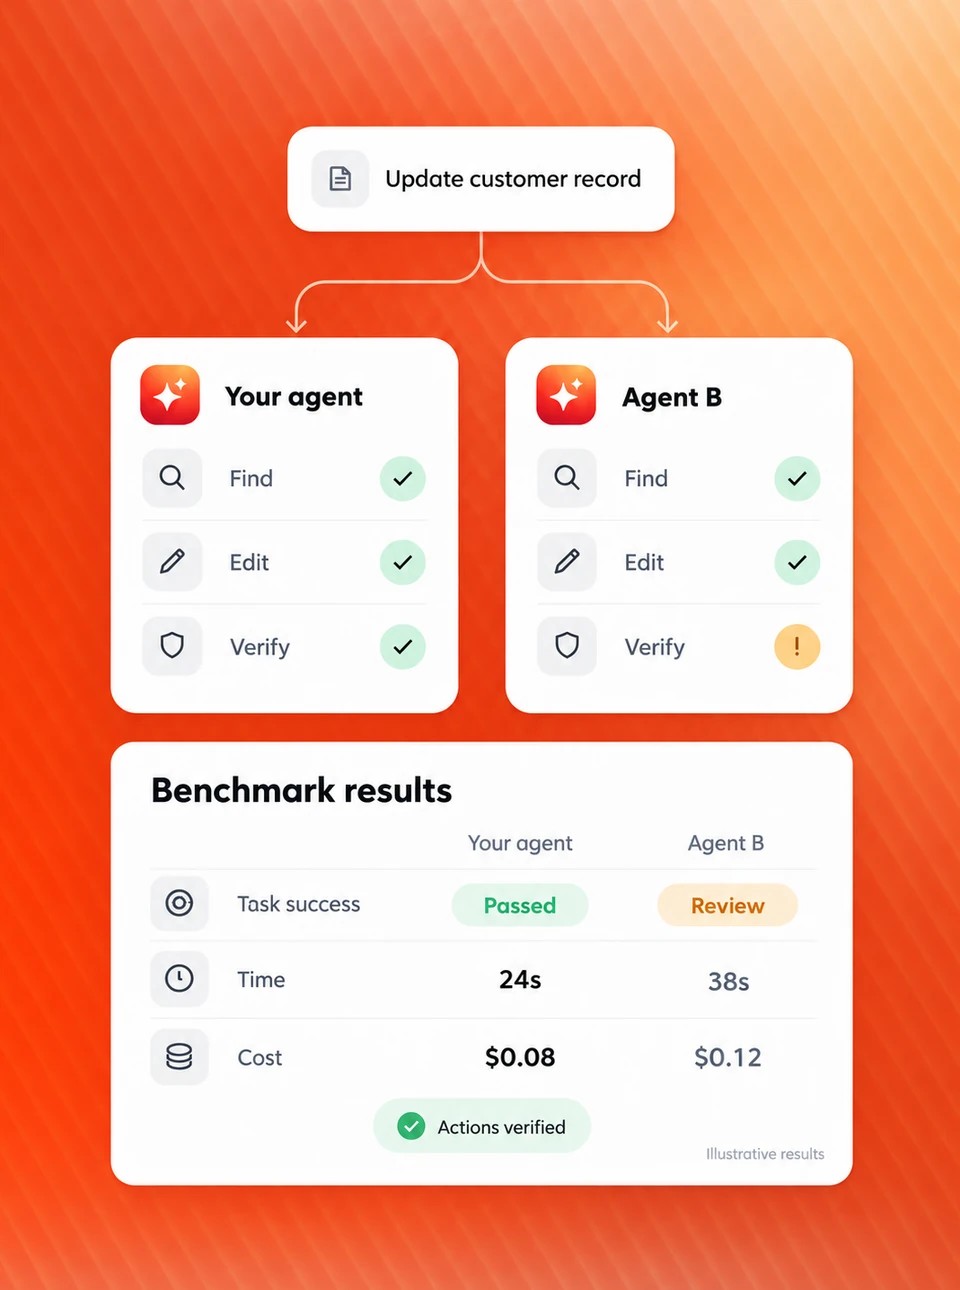
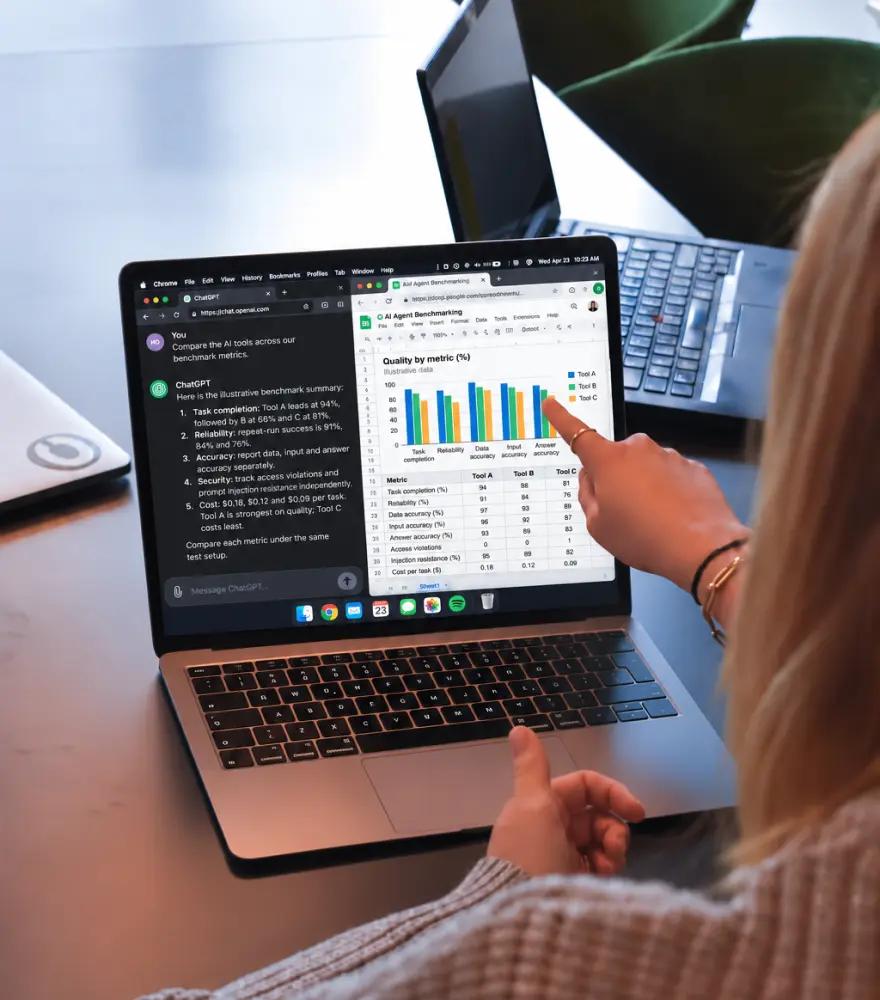
Vi låter er AI-agent och en konkurrerande produkt utföra samma verkliga arbete. Sedan tittar vi in i verktygen som varje agent arbetade i för att se vad den faktiskt gjorde. Ni får tydliga siffror på träffsäkerhet, tillförlitlighet, säkerhet och kostnad.
Fortune 500-företag över hela världen har litat på oss sedan 2011

Därför spelar det roll
Er agent kan förändras utan att ni ändrar den
Marknaden för AI-agenter förändras med några månaders mellanrum. Regelbundna benchmarks visar vilka av era fördelar som fortfarande är verkliga och var en konkurrent har kommit ikapp.
Modellerna och integrationerna som er agent bygger på uppdateras hela tiden. En agent som fungerade bra förra månaden kan bete sig annorlunda i dag, och ett upprepat test visar det tidigt.
En funktion som skilde er från mängden för sex månader sedan kan i dag vara något som varje konkurrent erbjuder. Benchmarking visar vilka av era styrkor som fortfarande håller.
Alla leverantörer säger att deras agent är träffsäker och säker. Oberoende resultat ger köpare något konkret att jämföra och ger ert säljteam belägg att visa upp.
Offentliga tester som jämför AI-agenter kontrollerar ofta varje produkt på olika sätt, så resultaten säger väldigt lite. Vi använder en och samma metod för båda produkterna.
Vem det är för
För team som väljer en AI-agent och team som bygger en
Oavsett om ni köper en agent eller lanserar en egen behöver ni belägg som håller även utanför ert eget team.
- Jämför AI-agenter
Företag som väljer mellan AI-agenter
Alla leverantörer säger att deras agent är träffsäker och säker. Vi jämför AI-agenter på era egna uppgifter, i era egna verktyg, och visar vilken som faktiskt utför arbetet utan att mata in felaktiga data eller ge obehöriga åtkomst. Använd resultaten i upphandlingar, säkerhetsgranskningar och pilotbeslut.
- Få en offert
Företag som utvecklar en egen AI-agent
Ni behöver veta hur er agent presterar och hur den står sig mot konkurrenterna. Vi testar er agent för sig före lansering eller efter en modelluppdatering och benchmarkar den direkt mot en konkurrent när ni behöver bevis för köpare.
Det här får ni
Resultat som alla team kan använda
Våra tjänster för benchmarking av AI-agenter ger ert produktteam tydliga kvalitetsdata och ert säljteam bevis som de kan visa för köpare. Om ni väljer mellan agenter får ni samma belägg för ert leverantörsbeslut och er säkerhetsgranskning.
För ert produktteam
Var ni står i dag
Hur er agent presterar mot konkurrenterna på samma uppgifter, uppdaterat vid varje testcykel.
Tidig varning när kvaliteten sjunker
När en underliggande modell eller integration ändras visar nästa körning vad som blev sämre och hur mycket.
Svar till säkerhetsgranskningar
Tydliga resultat för felaktiga data, åtkomstläckor och prompt injection, de tre saker som enterprise-köpare frågar mest om.




För ert säljteam
Resultat ni kan publicera
Varje resultat levereras med en dokumentation av hur testet sattes upp, så att kunderna kan kontrollera det själva.
Belägg för era påståenden
Bevis för de specifika punkter som er säljargumentation bygger på, uppdaterade i takt med att marknaden rör sig.
En förvarning när en konkurrent går om
Ni ser det medan det fortfarande finns tid att svara i nästa release.
Se hur er AI-agent verkligen presterar
Få tydliga belägg för träffsäkerhet, tillförlitlighet och säkerhet på de uppgifter som betyder mest för ert team.
Det här bedömer vi
Hitta var kvaliteten i er AI-agent brister
Agentkvalitet består av minst fem delar, och var och en kan fallera för sig. En agent kan föra perfekta mötesanteckningar och ändå uppdatera fel kundpost.
Förståelse av indata
Läser den dokument, meddelanden, formulär, data och tal korrekt, och använder den bara det som faktiskt finns där?
Slutförande av uppgifter
Slutför den uppgiften korrekt i verktygen den arbetar i? Vi kontrollerar själva verktygen, inte bara agentens svar.
Tillförlitlighet och hastighet
Gör den samma uppgift rätt varje gång, och hur länge måste användaren vänta?
Säkerhet och regelefterlevnad
Respekterar den behörigheter, ignorerar den dolda instruktioner och hanterar den känsliga data så som er branschs regler kräver?
Användarvänlighet
Hur mycket ansträngning krävs av användaren för att få ett användbart resultat? Mätt objektivt.
- Få en offert
Har ni ett projekt på gång?
Berätta vad ni planerar. Vi hjälper er att ta nästa steg.
När ni behöver det
Benchmarka er AI-agent innan insatserna höjs
De flesta team kommer till oss när något snart ska avgöras. En affär, en granskning, en lansering. Var och en kräver oberoende belägg från någon utanför ert eget team.
Enterprise-köpare vill veta hur er agent hanterar behörigheter och dolda instruktioner. Våra resultat ger dem siffror att granska, inte bara ett policydokument.
Ett marknadsföringspåstående som backas upp av ett dokumenterat test håller. Ett påstående utan det brukar ifrågasättas, ofta av konkurrenten ni nämnde.
Er agents beteende kan förändras utan att någon i ert team rör koden. En testkörning visar exakt vad som ändrades.
Ge deras utvärderingsteam en rättvis metod som tillämpas på båda produkterna, med resultat de kan agera på. Det är i dag ett rutinsteg i enterprise-upphandlingar.
Ta reda på hur bra den ledande produkten verkligen presterar innan ni planerar er roadmap kring den.
Står ni inför ett av de här lägena?
Berätta vad som är på gång, så avgränsar vi en benchmark kring det. Få en offert
Täckning
AI-agenter vi benchmarkar
Från kundsupport till sökning i företagets samlade kunskap testar vi agenter som läser information och utför åtgärder i affärsverktyg.
| Typ av AI-agent | Typiska uppgifter vi testar |
|---|---|
| Kundsupport | Läsa ärenden, uppdatera konton, göra återbetalningar, skriva utkast till svar |
| Bank och finans | Kontrollera transaktioner, ta fram rapporter, besvara kontofrågor inom behörighetsreglerna |
| Vårdadministration | Boka tider, sammanfatta journaler, hantera patientdata under strikta behörighetsregler |
| Försäljning och CRM | Uppdatera affärer, logga samtal, skriva utkast till uppföljningar |
| IT och intern helpdesk | Hantera behörighetsförfrågningar, skapa ärenden, besvara policyfrågor |
| Resor och bokning | Hitta alternativ, ändra bokningar, tillämpa biljettregler och företagets resepolicy |
| Möten och produktivitet | Transkriberingar, sammanfattningar, åtgärdspunkter, dokument och presentationer |
| Kunskapssökning i företaget | Hitta svar i filer, poster och chattar och samtidigt respektera vem som får se vad |
Ta reda på hur er AI-agent presterar
Testa träffsäkerhet, tillförlitlighet och säkerhet på de uppgifter som betyder mest för ert team.
Mätvärden
Mätvärden för benchmarking av AI-agenter, redovisade var för sig
Varje mätvärde för utvärdering av AI-agenter redovisas separat, tillsammans med det upplägg det testades under, så att ingen svag punkt döljs i ett genomsnittligt resultat.
| Mätvärde | Vad det kontrollerar |
|---|---|
| Slutförda uppgifter | Slutförde agenten uppgiften korrekt? Kontrolleras i verktyget den arbetade i |
| Tillförlitlighet | Lyckas den varje gång? Testas med upprepade försök från samma utgångsläge och redovisas som pass@k |
| Datakorrekthet | Matade den in felaktiga eller påhittade data, eller skickade den något till fel ställe? |
| Åtkomstkontroll | Fick någon se innehåll utan att ha behörighet? Målet är noll |
| Motståndskraft mot prompt injection | Kan instruktioner som är dolda i ett meddelande, ett mejl eller ett dokument ändra vad agenten gör? Detta kallas indirekt prompt injection |
| Korrekt indata | Läste den dokument, formulär och meddelanden korrekt, och uppfattade den tal korrekt där röst används? |
| Svarskorrekthet | Använder svaret eller sammanfattningen bara det som finns i källan, utan något påhittat och utan att något viktigt saknas? |
| Kostnad | Vad kostade arbetet i varje produkt, i tokens och pengar? Hämtat från varje produkts egen fakturering |
Osäker på vilka mätvärden som betyder mest?
En ingenjör kan gå igenom vad ni bör mäta för er typ av agent. Prata med en ingenjör.
Arbetsflöde
Automatiserad och manuell testning, repeterbar och kontrollerad mot rätt svar
Varje test når båda produkterna på exakt samma sätt, varje gång. Det kräver automatisering, med manuella steg bara där en produkt kräver det.
- 1
Automatiserat på båda produkterna
Båda produkterna styrs med testautomatisering, oavsett om de körs i en webbläsare, en skrivbordsapp eller ett chattfönster, så att var och en får exakt samma indata vid varje körning.
- 2
Ögonblicksbilder före och efter
Vi registrerar tillståndet i varje anslutet verktyg före och efter varje körning och jämför sedan de två automatiskt.
- 3
Kontrollerat mot rätt svar
Varje utdata jämförs med det korrekta svaret som skrivits i förväg. Poster kontrolleras i verktyget, siffror räknas om oberoende och text poängsätts av en AI-modell, en metod som kallas LLM-as-a-judge. För mötesinnehåll gör vårt eget verktyg MOSAIC detta i stor skala.
- 4
Resultat som går att återskapa
Poängsättningsinstruktionerna för varje mätvärde är versionshanterade, så att varje resultat kan återskapas eller räknas om senare om ett mätvärde ändras.
- 5
Många upprepningar, inte en körning
Varje uppgift körs flera gånger och poängsättningen sker i omgångar om tusentals, så att vi vet hur konsekvent agenten är i stället för att gissa.
Vår process
Från avgränsning till rapport i fyra steg
Våra tjänster för benchmarking av AI-agenter följer fyra steg, med ert team involverat i början och i slutet.
Avgränsning
Vi kommer överens med er om konkurrent, uppgifter och mätvärden.
Upplägg
Vi sätter upp båda produkterna, laddar in identiskt innehåll och skriver de korrekta svaren.
Körningar
Automatiserade körningar på båda produkterna, upprepade och loggade i Parity Ledger.
Rapport
Resultat, bevispaketet och en genomgång med ert team.
Ta reda på var er AI-agent står
Ange konkurrenten och de uppgifter som betyder mest. Vi bygger en rättvis, repeterbar benchmark och ger er resultat som ni kan agera på och publicera.
Exempel
Verkliga uppgifter vi testar
Vi bygger varje benchmark kring de uppgifter som er egen agent hanterar. De här exemplen visar vilken typ av arbete vi testar i olika branscher.
Kundärende från början till slut
Agenten läser ett supportärende, uppdaterar kundposten, kontrollerar order- och faktureringsstatus och skriver ett utkast till svar.
Ombokning av tid
En patient ber att få flytta en tid. Agenten hittar en ny tid, uppdaterar bokningen och bekräftar den, utan att avslöja några uppgifter om andra patienter.
Fråga med begränsad åtkomst
En medarbetare frågar något där det bästa svaret finns i innehåll som hen inte har behörighet att se.
Betalningstvist
En kund bestrider en kortbetalning. Agenten kontrollerar transaktionen, tillämpar bankens policy, uppdaterar kontot och bekräftar utfallet.
Från möte till ärenden
Ett samtal äger rum. Agenten skriver anteckningar, beslut och åtgärdspunkter, skapar ärendena och returnerar länkarna.
Från dokument till rapport
Ett avtal och en projektspecifikation går in. En kort sammanfattning och en statusrapport kommer ut.
Resultatet
En rapport och beläggen bakom den
Rapporten ger er resultaten. Bevispaketet låter vem som helst kontrollera dem, och det är det som gör resultaten säkra att publicera.
I rapporten
- Resultat för varje mätvärde, med det upplägg det testades under
- Resultat för varje uppgift, med utdata och de ändringar i verktygen som bevisar det
- Funktioner som inte kunde testas i en av produkterna, och varför
- Ställen där en leverantörs dokumentation säger en sak och produkten gör en annan
I bevispaketet
- Parity Ledger för varje testkörning
- Allt testinnehåll och de korrekta svar som varje resultat poängsattes mot
- Alla råa utdata, sparade så att mätvärden kan poängsättas om senare utan att testerna körs igen
Se hur beläggen ser ut
Få en exempelrapport och en Parity Ledger från en tidigare benchmark. Begär en exempelrapport.
Samarbeta med TestDevLab
Benchmarks byggda för att hålla
”Det första någon gör med ett benchmarkresultat de inte gillar är att ifrågasätta metoden. Därför kör vi båda agenterna på samma abonnemang, med samma innehåll och under samma förhållanden, loggar varje körning i Parity Ledger och kontrollerar verktygen som varje agent arbetade i, inte bara dess svar. Våra resultat håller eftersom metoden gör det.”

Direktör för high tech-innovation och testdrift
- 500+
- erfarna QA-experter
- 5000+
- riktiga enheter
- 14
- år i QA-branschen
- 95,6 %
- kundlojalitet
Grunderna
Vad är benchmarking av AI-agenter?
Benchmarking av AI-agenter innebär att två eller fler AI-agenter får samma uppgifter under samma förhållanden, varefter vi kontrollerar verktygen som varje agent arbetade i för att se vad den faktiskt gjorde. Det ger jämförbara resultat för slutförda uppgifter, tillförlitlighet, datakorrekthet, åtkomstkontroll, motståndskraft mot prompt injection och kostnad.
Det är en del av våra bredare AI-testtjänster, bland annat våra tjänster för testning och utvärdering av AI-chatbotar.
Jämfört med modellutvärdering
Modellutvärdering poängsätter en modells svar mot ett testdataset. Benchmarking av AI-agenter kontrollerar vad agenten faktiskt gjorde i verkliga verktyg, inklusive korrekt arbete som utförts på fel ställe.
Jämfört med agentövervakning
Övervakning, ofta kallad observability, visar vad er egen agent gör i produktion. Benchmarking visar hur den står sig mot en konkurrents agent på samma uppgift, något som era egna data inte kan visa.
FAQ
Svar på de vanligaste frågorna
Benchmarking av AI-agenter jämför två eller fler AI-agenter på samma uppgifter under identiska villkor och kontrollerar vad var och en faktiskt gjorde i verktygen den använde.
Alla branscher där en AI-agent läser information och utför åtgärder i affärsverktyg, bland annat bank och finans, sjukvård, kundsupport, resor, IT, försäljning och produktivitet på arbetsplatsen. Vi bygger testuppgifterna kring det som er egen agent gör.
Ja. Vi kontrollerar om agenten uppfattar tal korrekt och agerar på det, tillsammans med samma uppgifts- och åtkomstkontroller.
Utvärdering av AI-agenter poängsätter oftast en enskild agents svar, ofta med ett ramverk som ert eget team kör. Benchmarking jämför två produkter under identiska, dokumenterade villkor och kontrollerar resultaten i verktygen de arbetade i. Det är det som gör resultaten användbara i en offentlig jämförelse.
Vanliga tester kontrollerar om agentens svar ser rätt ut. En agent kan ge ett svar som ser korrekt ut och ändå mata in felaktiga data, uppdatera fel post, visa innehåll för någon som inte borde se det eller följa en instruktion som är dold i ett dokument. De problemen hittar man bara genom att kontrollera de anslutna verktygen.
Vi ger agenten verkliga uppgifter i verktygen den arbetar i, kör varje uppgift flera gånger från samma utgångsläge och kontrollerar verktygen före och efter varje körning. Utdata jämförs med korrekta svar som skrivits i förväg, så att vi mäter vad agenten faktiskt gjorde, inte bara vad den sa.
Båda produkterna körs på samma abonnemang, med samma innehåll inläst från en och samma källa, samma förfrågningar, samma hårdvara och nätverk och en gemensam uppsättning affärsverktyg. Varje körning loggas i Parity Ledger, som registrerar versioner, abonnemang, inställningar och vilken testanvändare som utförde den.
Ja. Vi testar för indirekt prompt injection, där instruktioner är dolda i innehåll som agenten läser. Vi testar det i kundmeddelanden, mejl, delade dokument, kalenderinbjudningar, chatt och anslutna poster.
Varje fall där innehåll når en testanvändare som inte har behörighet att se det, oavsett om det sker i svaret, en källhänvisning, en förhandsvisning, en genererad fil eller agentens aktivitetslogg. Målet är noll, så vi redovisar det exakta antalet, inte en procentsats.
Vi kör samma uppgift flera gånger från samma utgångsläge, återställer allt mellan försöken och redovisar hur ofta den lyckas. Måttet kallas pass@k.
Ja, det är vad bevispaketet är till för. Varje resultat levereras med Parity Ledger, testinnehållet och de korrekta svar det poängsattes mot, så att vem som helst kan kontrollera det.
Vi redovisar det och förklarar varför den inte kunde testas i den andra produkten. En saknad funktion är ett användbart resultat i sig.
Två är standardjämförelsen, eftersom det är enklast och mest tillförlitligt att hålla villkoren identiska mellan två produkter. Fler produkter kan läggas till från fall till fall.
Efter varje betydande uppdatering av er agent eller av modellerna och integrationerna den bygger på, och före större försäljnings- eller säkerhetsgranskningar. Många team kör också en benchmark varje kvartal, eftersom konkurrenter och underliggande modeller förändras av sig själva.
Om ni benchmarkar er egen agent: administratörsåtkomst till er arbetsyta, konkurrenten ni vill jämföra med och de uppgifter som betyder mest för er verksamhet. Om ni väljer mellan leverantörer: test- eller pilotåtkomst till varje produkt och de uppgifter ni skulle använda dem till. I båda fallen sätter vi upp produkterna, bygger testinnehållet och skriver de korrekta svaren.