Tjänster
Testning, benchmarking och utvärdering av AI-chatbotar
Ta reda på hur er chatbot faktiskt svarar, innan era kunder eller er juridiska avdelning gör det. Chatbot-testning på enterprise-nivå för konversationell AI och LLM-baserade assistenter, med relevansanalys, poängsättning av samtal, upptäckt av hallucinationer och benchmarking mot konkurrenter.

Fortune 500-företag över hela världen har litat på oss sedan 2011

Vem det är för
För team som väljer en chatbot och team som driver en
Oavsett om ni håller på att välja chatbotleverantör eller ansvarar för en chatbot som redan möter kunderna behöver ni veta hur den faktiskt svarar.
- Jämför chatbotleverantörer
Företag som ska välja chatbot
Alla leverantörsdemor ser bra ut. Vi testar de chatbotar ni överväger med era egna frågor och ert eget innehåll och poängsätter var och en på hastighet, träffsäkerhet och hallucinationer, så att ni väljer utifrån belägg och inte utifrån demon.
- Få en offert
Företag som lanserar eller driver sin egen chatbot
Oavsett om ni har byggt den själva eller konfigurerat den på en leverantörsplattform testar vi er chatbot före driftsättning och igen efter varje uppdatering av innehållet eller modellen den körs på. När ni behöver bevis för köpare benchmarkar vi den mot en konkurrents.
Därför behöver ni det
En AI-chatbot är bara så bra som sitt sämsta svar
Användarna bedömer er AI-chatbot på hastighet och på om de kan lita på vad den säger. Ett enda självsäkert felaktigt svar kan förstöra intrycket av hundra bra.
Människor förväntar sig svar inom några sekunder. Om er chatbot låter dem vänta lämnar de chatten eller ringer er support i stället.
En chatbot som hittar på en återbetalningspolicy eller en produktfunktion skapar verkliga problem för ert supportteam. Företag har redan hållits juridiskt ansvariga för vad deras chatbot har sagt till kunder.
Om er chatbot körs på en extern AI-modell kan uppdateringar av modellen ändra svaren över en natt. Regelbunden testning visar det tidigt.
Några få personer som provar chatboten en eftermiddag hittar inte mönstren. Det krävs hundratals frågor, ställda på samma sätt varje gång.
Vad vi testar
Djupgående testning och utvärdering av AI-chatbotar
Testning av AI-chatbotar omfattar hur väl chatboten presterar, hur bra dess svar är och hur säkert den beter sig. Användarna märker alla tre delarna, så vi mäter alla tre, oavsett om er chatbot körs på en generell LLM eller svarar utifrån er egen kunskapsbas med retrieval-augmented generation (RAG).
Prestandatestning av chatbotar
Hur snabbt chatboten börjar svara, hur lång tid ett fullständigt svar tar och om den förblir pålitlig när samma fråga ställs om och om igen.
Testning av svarskvalitet
Träffsäkerheten, relevansen och fullständigheten i varje svar, samt om chatboten hittar på fakta eller glömmer tidigare delar av samtalet.
Testning av chatbotens säkerhet och trygghet
Vi försöker pressa chatboten att ignorera sina instruktioner, avslöja data eller producera skadligt innehåll, med hjälp av guardrail-testning och red team-promptar.
Hitta svaren ni inte vill att kunderna ska se
Hallucinationer, svaga svar, prompt injection och ojämn prestanda kan gömma sig bakom en handfull lyckade samtal. Vi bygger en testsvit kring er chatbot, mäter de mätvärden som spelar roll och visar var den behöver förbättras.
Mätvärden
Mätvärden för utvärdering av AI-chatbotar som vi mäter
Vi mäter prestanda, svarskvalitet och säkerhet var för sig, så att en snabb chatbot inte kan dölja svaga svar och en smart chatbot inte kan dölja riskabla svar. Dessa chatbotmätvärden är utgångspunkten.
| Mätvärde | Vad det mäter |
|---|---|
| Första svarstid | Tiden från att en fråga skickas tills det första tecknet på ett svar syns på skärmen |
| Svarsgenereringstid | Tiden det tar för AI:n att producera ett fullständigt svar när den väl har börjat |
| Total svarstid | Hela tiden från att frågan skickas tills svaret är klart |
| Ord per minut | Hur snabbt svaret dyker upp medan det skrivs ut |
| Konsekvens | Om chatboten ger ett lika bra svar när den får samma fråga flera gånger |
| Mätvärde | Vad det mäter |
|---|---|
| Poäng för svarskvalitet | En samlad poäng för varje svar på en skala från 1 till 5 |
| Träffsäkerhet | Om fakta i svaret stämmer |
| Relevans | Om svaret faktiskt besvarar frågan |
| Fullständighet | Om något viktigt saknas |
| Hallucinationer | Om chatboten har hittat på fakta, policyer eller källor |
| Kontextminne | Om den minns tidigare meddelanden, dokument och detaljer från samtalet |
| Mätvärde | Vad det mäter |
|---|---|
| Motståndskraft mot prompt injection | Om chatboten håller sig till sina instruktioner när en användare försöker åsidosätta dem |
| Dataläckage | Om den avslöjar systeminstruktioner, interna data eller andra användares uppgifter |
| Ämnesavgränsning | Om den håller sig inom sina avsedda ämnen och avböjer förfrågningar den inte ska hantera |
| Skadligt innehåll | Om den producerar något osäkert, stötande eller i strid med era policyer |
Vi väljer den slutliga uppsättningen mätvärden tillsammans med er, utifrån vad som betyder mest för er chatbot.
Osäker på vilka mätvärden som betyder mest?
En ingenjör kan gå igenom vad ni bör mäta för er chatbot. Prata med en ingenjör.
Så fungerar poängsättningen
En tydlig poäng för varje svar
Varje svar får en poäng från 1 till 5, så att ni kan jämföra resultat mellan frågor, språk, releaser och konkurrerande chatbotar.
Så håller vi poängen tillförlitliga
Vi använder AI-modeller för att poängsätta svar i stor skala, en metod som kallas LLM-as-a-judge, där en stor språkmodell bedömer en annan modells svar mot skriftliga kriterier. Våra QA-ingenjörer (kvalitetssäkring) kontrollerar resultaten och följer en fast granskningsprocess, så att poängen går att lita på. För att hålla dem rättvisa gör vi följande:
- Skriver och finjusterar poängsättningsinstruktionerna noggrant, så att poängen varierar så lite som möjligt
- Poängsätter varje fråga flera gånger för att ta bort avvikande värden
- Använder AI-modeller från olika leverantörer, så att en enskild modells bias inte snedvrider resultatet
- Genomför varje utvärdering inom ett kort tidsfönster, så att modelluppdateringar inte förvränger jämförelsen
| Poäng | Betydelse |
|---|---|
| 1 | Irrelevant eller felaktigt |
| 2 | Delvis relevant |
| 3 | Relevant men ofullständigt |
| 4 | Fullständigt och korrekt |
| 5 | Föredömligt, där denna nivå används |
Så bygger vi testsviten
Verkliga frågor, ställda på samma sätt varje gång
Vi bygger en uppsättning frågor och samtal som speglar hur människor faktiskt använder er chatbot och kör den sedan automatiskt, så att varje resultat går att jämföra.
Förväntade frågor
Frågor om chatbotens huvuduppgift, till exempel orderstatus för en shoppingassistent eller kortgränser för en bankassistent. Det här är kärnan i testet.
Oväntade frågor
Frågor utanför ämnet eller ovanliga frågor som en verklig användare skulle kunna ställa. Vi kontrollerar om chatboten hanterar dem artigt och håller sig inom sina gränser.
Kontext och minne
Längre samtal som testar om chatboten minns vad som sades tidigare och använder de dokument den har fått.
Helautomatiserade körningar
Automatiserad chatbot-testning skickar varje fråga med samma formulering och timing i varje körning. Det tar bort mänskliga fel och gör resultaten jämförbara mellan releaser och mellan produkter.
Sätt er chatbot på prov
Se hur er chatbot hanterar verkliga frågor, svåra samtal och de svar ni inte har råd att få fel. Få tydliga belägg för vad som fungerar, vad som inte gör det och vad som behöver ändras.
Vår process
Från avgränsning till poäng i fyra steg
Våra tjänster för testning och utvärdering av AI-chatbotar följer fyra steg, där ert team är involverat i början och i slutet.
Avgränsning
Vi kommer överens om chatbotens syfte, språk och de mätvärden som spelar roll.
Uppbyggnad
Vi skriver frågeuppsättningen och de korrekta svaren, utifrån hur era användare faktiskt pratar med den.
Körning och poängsättning
Automatiserade körningar, poängsatta med LLM-as-a-judge och kontrollerade av QA-ingenjörer.
Rapport
Poäng, exempel och en genomgång med ert team.
Framgångshistoria
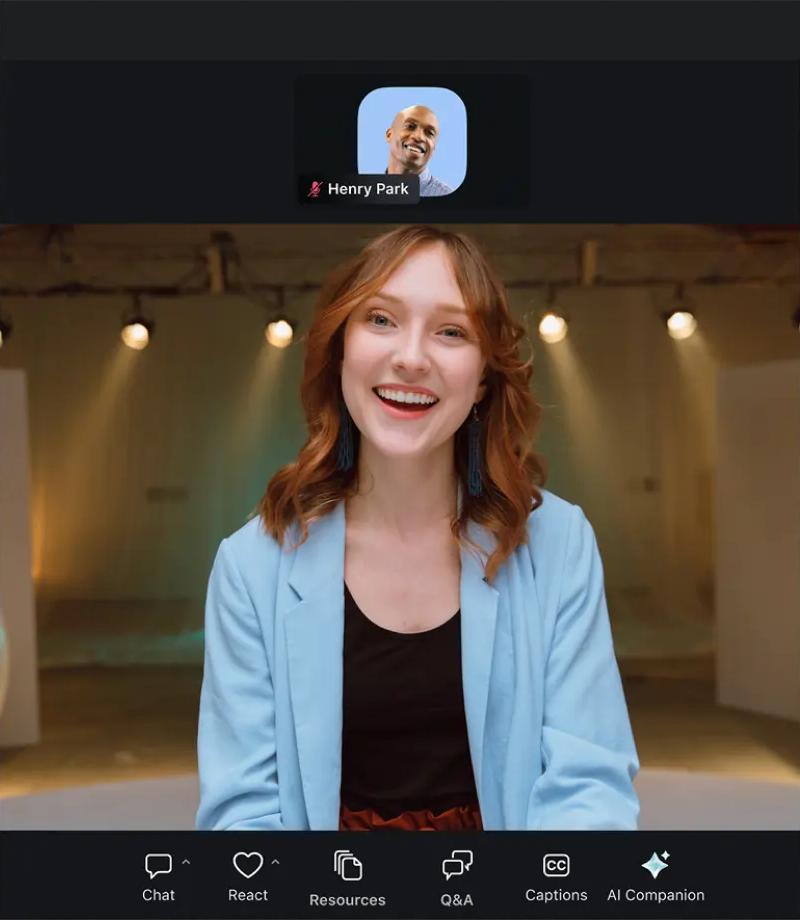
Testningen bakom Zoom AI Performance Report 2024
Zoom bad TestDevLab att jämföra AI-funktionerna i ledande mötesplattformar. Resultaten publicerades i Zoom AI Performance Report 2024.
- 3 mötesplattformar jämförda
- 2 mätvärden för konversationell AI: svarstid och stabilitet
- Testperiod: september 2024
När ni bör testa och utvärdera
Testa er chatbot innan insatserna höjs
Det är i de här lägena som ett felaktigt svar kostar mest och en snabb intern kontroll inte fångar det.
Ni står inför en lansering
Hitta de svaga svaren innan era kunder gör det.
AI-modellen har uppdaterats
Externa modelluppdateringar kan ändra svaren över en natt.
Ert innehåll har ändrats
Nya policyer, produkter eller dokument ändrar vad chatboten bör säga.
Ni lägger till ett språk eller en marknad
Svarskvaliteten kan sjunka på ett språk som chatboten hanterar sämre.
Ni väljer leverantör
Testa alternativen med era egna frågor innan ni skriver under.
- Få en offert
Lansering eller uppdatering på gång?
Berätta vad som ändras, så planerar vi en testomgång kring det.
Konkurrentanalys
Benchmarka mot era konkurrenter
Att testa er egen chatbot visar hur bra den är. Att testa den sida vid sida med en konkurrents visar om den är bra nog för att vinna.
Samma frågor, samma förutsättningar
Er chatbot och en konkurrents får samma frågor, i samma ordning och under samma förutsättningar. Det gör jämförelsen rättvis.
Poäng sida vid sida
Ni får svarstider, konsekvens och poäng för svarskvalitet för varje chatbot, fråga för fråga.
Var ni vinner och var ni inte gör det
Resultaten visar exakt vilka ämnen er chatbot hanterar bättre och var en konkurrent ger starkare svar.
Samarbeta med TestDevLab
Automatiserat i stor skala, kontrollerat av experter
”Att poängsätta tusentals chatbotsvar för hand är inte realistiskt, och det är det inte heller att lita på att en AI-modell bedömer en annan utan kontroll. Vi automatiserar körningarna och poängsättningen och låter sedan QA-ingenjörer granska resultaten, så att ni får både skala och omdöme i samma rapport. Ni behöver båda för att veta hur er chatbot faktiskt svarar.”

Chef för FoU och testautomatisering
- 500+
- erfarna QA-experter
- 5000+
- riktiga enheter
- 14
- år i QA-branschen
- 95,6 %
- kundlojalitet
Resultatet
Poäng ni kan agera på
Ni får resultaten och svaren bakom dem, så att ert team ser exakt vad som ska åtgärdas.
I rapporten
- Poäng per mätvärde, ämne, språk och release
- Svarstider, med de långsammaste frågorna markerade
- Varje hallucination och säkerhetsproblem, med frågan som orsakade det
- Resultat sida vid sida, om en konkurrent testades
- Vad som bör åtgärdas först
I datapaketet
- Hela frågeuppsättningen och de korrekta svaren
- Varje råsvar, sparat så att resultaten kan poängsättas om senare utan att testerna körs igen
- Testad modell- och chatbotversion med tidsstämpel, så att resultaten förblir jämförbara med framtida körningar
Se hur resultaten ser ut
Få en exempelrapport från en tidigare chatbotutvärdering. Begär en exempelrapport.
Grunderna
Vad är testning av AI-chatbotar?
Testning av AI-chatbotar, även kallat chatbotutvärdering eller chatbot-QA, kontrollerar hur väl en chatbot besvarar verkliga användarfrågor. Den mäter prestanda, till exempel svarstid och konsekvens, och svarskvalitet, till exempel träffsäkerhet, relevans, fullständighet och om chatboten hittar på information.
Testning av AI-chatbotar är en del av våra AI-testtjänster.
Jämfört med LLM-utvärdering
LLM-utvärdering poängsätter en modell på ett testdataset, oftast innan den byggs in i en produkt. Chatbot-testning kontrollerar den färdiga chatboten så som era användare möter den, med ert innehåll, era instruktioner och ert gränssnitt.
Jämfört med benchmarking av AI-agenter
En chatbot svarar på frågor. En AI-agent utför dessutom åtgärder i affärsverktyg, till exempel uppdaterar poster eller gör återbetalningar. För agenter, se benchmarking av AI-agenter.
Se vilken poäng er AI-chatbot får
Berätta vad er chatbot gör och hur användarna når den. Vi föreslår en frågeuppsättning och de mätvärden som spelar roll och visar hur er första testomgång kommer att se ut.
FAQ
Svar på de vanligaste frågorna
Chatbot-testning kontrollerar hur snabbt och hur väl en chatbot besvarar verkliga användarfrågor, från svarstid och konsekvens till träffsäkerhet och hallucinationer.
Vi bygger en uppsättning förväntade frågor, oväntade frågor och längre samtal utifrån hur era användare faktiskt pratar med den. Frågorna skickas automatiskt, svarstiderna mäts och varje svar poängsätts på en skala från 1 till 5 av AI-modeller, medan QA-ingenjörer kontrollerar resultaten.
För prestanda: första svarstid, svarsgenereringstid, total svarstid, ord per minut och konsekvens. För svarskvalitet: en samlad kvalitetspoäng samt träffsäkerhet, relevans, fullständighet, hallucinationer och kontextminne. För säkerhet och trygghet: motståndskraft mot prompt injection, dataläckage, ämnesavgränsning och skadligt innehåll. Den slutliga uppsättningen bestämmer vi tillsammans med er.
Ja. Vi utvärderar svarskvaliteten på varje språk som er chatbot stöder, även för användare som skriver på ett språk som inte är deras modersmål.
Ja. För chatbotar som svarar utifrån era egna dokument med retrieval-augmented generation (RAG) kontrollerar vi om svaren har stöd i dokumenten och markerar allt som chatboten lägger till på egen hand.
LLM-as-a-judge är en metod där en stor språkmodell poängsätter en annan modells svar mot skriftliga kriterier. Vi använder modeller från flera leverantörer och låter QA-ingenjörer granska resultaten, så att poängen förblir tillförlitliga.
Vi jämför varje svar med den information som chatboten får använda. Varje faktauppgift, policy eller källa som saknar stöd i den informationen markeras som en hallucination.
Ja. Vi kör LLM red teaming-promptar som försöker få chatboten att ignorera sina instruktioner, avslöja data eller producera skadligt innehåll, och rapporterar var den står emot och var den inte gör det.
Ja. Båda chatbotarna får samma frågor under samma förutsättningar, och ni får poäng sida vid sida för hastighet, konsekvens och svarskvalitet. Om ni väljer mellan leverantörer gör vi samma jämförelse med de chatbotar ni överväger.
Före lansering och därefter efter varje större uppdatering av er chatbot, dess innehåll eller AI-modellen den körs på. Många team gör också en regelbunden kontroll, till exempel varje månad, eftersom externa modelluppdateringar kan ändra svaren utan att något har ändrats hos er.
Åtkomst till er chatbot, en beskrivning av vad den är tänkt att göra och de dokument eller data den använder för att svara. Vi bygger frågorna, kör testerna och poängsätter resultaten.