Leistungen
KI-Agenten-Benchmarking
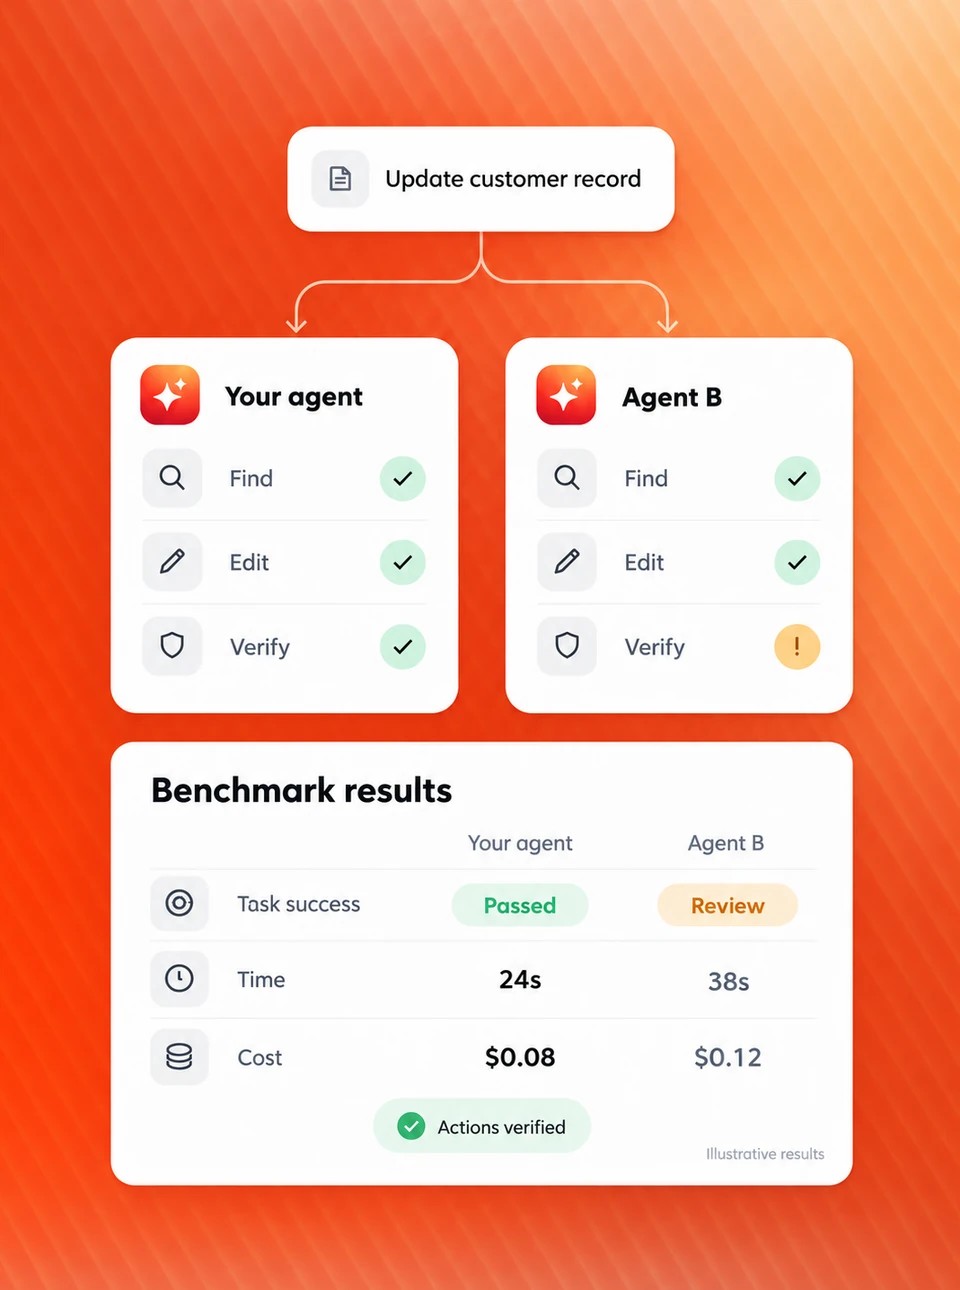
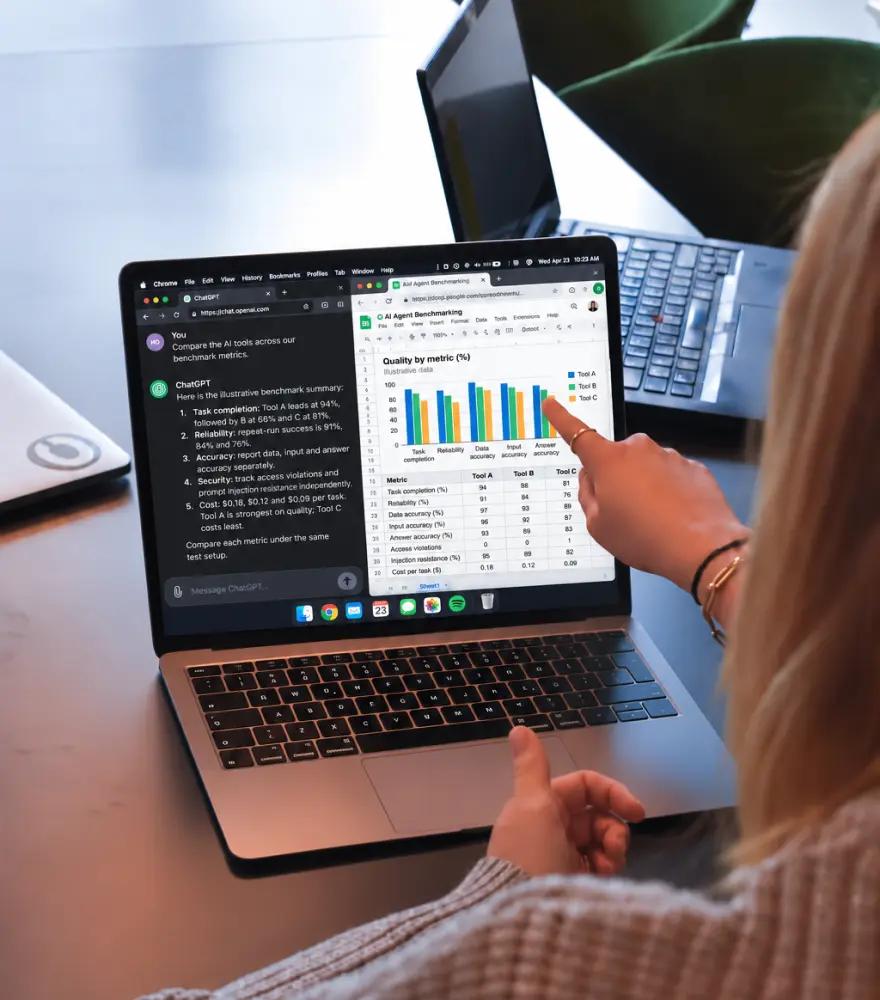
Wir lassen Ihren KI-Agenten und ein Konkurrenzprodukt dieselbe echte Arbeit erledigen. Dann prüfen wir in den Tools, in denen jeder Agent gearbeitet hat, was er tatsächlich getan hat. Sie erhalten klare Zahlen zu Genauigkeit, Zuverlässigkeit, Sicherheit und Kosten.
Fortune-500-Unternehmen weltweit vertrauen uns seit 2011

Warum es wichtig ist
Ihr Agent kann sich ändern, ohne dass Sie etwas ändern
Der Markt für KI-Agenten verändert sich alle paar Monate. Regelmäßige Benchmarks zeigen, welche Ihrer Vorteile noch bestehen und wo ein Wettbewerber aufgeholt hat.
Die Modelle und Integrationen, auf die Ihr Agent angewiesen ist, werden ständig aktualisiert. Ein Agent, der letzten Monat gut funktioniert hat, kann sich heute anders verhalten, und ein erneuter Test zeigt das frühzeitig.
Eine Funktion, mit der Sie sich vor sechs Monaten abgehoben haben, bietet heute vielleicht jeder Wettbewerber. Benchmarking zeigt Ihnen, welche Ihrer Stärken noch tragen.
Jeder Anbieter behauptet, sein Agent sei genau und sicher. Unabhängige Ergebnisse geben Käufern eine belastbare Vergleichsgrundlage und Ihrem Vertrieb Belege, die er teilen kann.
Öffentliche Tests, die KI-Agenten vergleichen, prüfen jedes Produkt oft auf andere Weise, sodass die Ergebnisse wenig aussagen. Wir verwenden eine Methode für beide Produkte.
Für wen
Für Teams, die einen KI-Agenten auswählen oder selbst entwickeln
Ob Sie einen Agenten einkaufen oder selbst ausliefern: Sie brauchen Belege, die auch außerhalb Ihres eigenen Teams standhalten.
- KI-Agenten vergleichen
Unternehmen, die zwischen KI-Agenten wählen
Jeder Anbieter behauptet, sein Agent sei genau und sicher. Wir vergleichen KI-Agenten anhand Ihrer eigenen Aufgaben in Ihren eigenen Tools und zeigen, welcher die Arbeit tatsächlich erledigt, ohne falsche Daten einzutragen oder Inhalte an Unbefugte preiszugeben. Nutzen Sie die Ergebnisse für Beschaffung, Sicherheitsprüfungen und Pilotentscheidungen.
- Angebot anfordern
Unternehmen, die einen eigenen KI-Agenten entwickeln
Sie müssen wissen, wie Ihr Agent abschneidet und wie er im Vergleich zur Konkurrenz dasteht. Wir testen Ihren Agenten für sich allein vor dem Launch oder nach einem Modell-Update und stellen ihn direkt einem Wettbewerber gegenüber, wenn Sie Belege für Käufer brauchen.
Was Sie erhalten
Ergebnisse, die jedes Team nutzen kann
Unsere Services für KI-Agenten-Benchmarking liefern Ihrem Produktteam klare Qualitätsdaten und Ihrem Vertrieb Belege, die er Käufern vorlegen kann. Wenn Sie zwischen Agenten wählen, erhalten Sie dieselben Belege für Ihre Anbieterentscheidung und Ihre Sicherheitsprüfung.
Für Ihr Produktteam
Wo Sie heute stehen
Wie Ihr Agent bei denselben Aufgaben im Vergleich zur Konkurrenz abschneidet, aktualisiert mit jedem Testzyklus.
Frühwarnung bei Qualitätsverlust
Wenn sich ein zugrunde liegendes Modell oder eine Integration ändert, zeigt der nächste Durchlauf, was schlechter geworden ist und um wie viel.
Antworten für Sicherheitsprüfungen
Klare Ergebnisse zu falschen Daten, Zugriffslecks und Prompt Injection, den drei Themen, nach denen Enterprise-Käufer am häufigsten fragen.




Für Ihren Vertrieb
Ergebnisse, die Sie veröffentlichen können
Zu jedem Ergebnis gibt es eine Dokumentation des Testaufbaus, sodass Kunden es selbst überprüfen können.
Belege für Ihre Aussagen
Nachweise für genau die Punkte, auf die sich Ihr Verkaufsargument stützt, aktualisiert, sobald sich der Markt bewegt.
Frühzeitiger Hinweis, wenn ein Wettbewerber vorbeizieht
Sie sehen es, solange noch Zeit bleibt, im nächsten Release zu reagieren.
Sehen Sie, was Ihr KI-Agent wirklich leistet
Erhalten Sie klare Belege zu Genauigkeit, Zuverlässigkeit und Sicherheit bei den Aufgaben, die für Ihr Team zählen.
Was wir prüfen
Finden Sie heraus, wo die Qualität Ihres KI-Agenten einbricht
Die Qualität eines Agenten besteht aus mindestens fünf Teilen, und jeder davon kann für sich versagen. Ein Agent kann perfekte Besprechungsnotizen schreiben und trotzdem den falschen Kundendatensatz aktualisieren.
Verständnis der Eingabe
Liest er Dokumente, Nachrichten, Formulare, Daten und Sprache korrekt und nutzt er nur, was tatsächlich vorhanden ist?
Aufgabenerfüllung
Erledigt er die Aufgabe korrekt in den Tools, in denen er arbeitet? Wir prüfen die Tools selbst, nicht nur die Antwort des Agenten.
Zuverlässigkeit und Geschwindigkeit
Löst er dieselbe Aufgabe jedes Mal richtig, und wie lange muss der Nutzer warten?
Sicherheit und Compliance
Respektiert er Zugriffsrechte, ignoriert er versteckte Anweisungen und behandelt er sensible Daten so, wie es die Vorschriften Ihrer Branche verlangen?
Benutzerfreundlichkeit
Wie viel Aufwand muss der Nutzer betreiben, um ein brauchbares Ergebnis zu erhalten? Objektiv gemessen.
- Angebot anfordern
Haben Sie ein Projekt im Sinn?
Erzählen Sie uns, was Sie planen. Wir helfen Ihnen beim nächsten Schritt.
Wann Sie es brauchen
Benchmarken Sie Ihren KI-Agenten, bevor viel auf dem Spiel steht
Die meisten Teams kommen zu uns, wenn eine Entscheidung bevorsteht. Ein Deal, eine Prüfung, ein Launch. Jede davon erfordert unabhängige Belege von außerhalb Ihres eigenen Teams.
Enterprise-Käufer wollen wissen, wie Ihr Agent mit Zugriffsrechten und versteckten Anweisungen umgeht. Unsere Ergebnisse liefern ihnen Zahlen zur Prüfung, nicht nur ein Richtliniendokument.
Eine Marketingaussage, die auf einem dokumentierten Test beruht, hält stand. Eine ohne diesen Test wird oft angefochten, nicht selten von dem Wettbewerber, den Sie genannt haben.
Das Verhalten Ihres Agenten kann sich ändern, ohne dass jemand in Ihrem Team den Code anfasst. Ein Testdurchlauf zeigt genau, was sich geändert hat.
Geben Sie dessen Evaluierungsteam eine faire Methode, angewendet auf beide Produkte, mit Ergebnissen, auf deren Basis es handeln kann. Das ist im Enterprise-Einkauf inzwischen ein Routineschritt.
Erfahren Sie, wie gut das führende Produkt wirklich abschneidet, bevor Sie Ihre Roadmap danach ausrichten.
Steht Ihnen einer dieser Momente bevor?
Erzählen Sie uns, was ansteht, und wir planen einen passenden Benchmark. Angebot anfordern
Abdeckung
KI-Agenten, die wir benchmarken
Vom Kundensupport bis zur internen Wissenssuche testen wir Agenten, die Informationen lesen und in Business-Tools handeln.
| KI-Agententyp | Typische Testaufgaben |
|---|---|
| Kundensupport | Tickets lesen, Konten aktualisieren, Erstattungen auslösen, Antworten entwerfen |
| Banken und Finanzen | Transaktionen prüfen, Berichte erstellen, Kontofragen im Rahmen der Zugriffsregeln beantworten |
| Gesundheitsverwaltung | Termine buchen, Akten zusammenfassen, Patientendaten unter strengen Zugriffsregeln verarbeiten |
| Vertrieb und CRM | Deals aktualisieren, Anrufe protokollieren, Follow-ups entwerfen |
| IT und interner Helpdesk | Zugriffsanfragen verwalten, Tickets anlegen, Fragen zu Richtlinien beantworten |
| Reisen und Buchung | Optionen finden, Buchungen ändern, Tarif- und Reiserichtlinien anwenden |
| Meetings und Produktivität | Transkripte, Zusammenfassungen, Aufgaben, Dokumente und Präsentationen |
| Interne Wissenssuche | Antworten in Dateien, Datensätzen und Chats finden und dabei beachten, wer was sehen darf |
Messen Sie, was Ihr KI-Agent leistet
Testen Sie Genauigkeit, Zuverlässigkeit und Sicherheit bei den Aufgaben, die für Ihr Team zählen.
Metriken
KI-Agenten-Benchmarking: Metriken einzeln ausgewiesen
Jede Metrik zur Bewertung von KI-Agenten wird einzeln ausgewiesen, zusammen mit dem Aufbau, unter dem sie getestet wurde, damit keine Schwachstelle in einem Durchschnittswert verschwindet.
| Metrik | Was geprüft wird |
|---|---|
| Aufgabenerfüllung | Hat der Agent die Aufgabe korrekt erledigt? Geprüft in dem Tool, in dem er gearbeitet hat |
| Zuverlässigkeit | Gelingt es ihm jedes Mal? Getestet mit wiederholten Versuchen vom selben Ausgangspunkt, ausgewiesen als pass@k |
| Datengenauigkeit | Hat er falsche oder erfundene Daten eingetragen oder etwas an die falsche Stelle gesendet? |
| Zugriffskontrolle | Hat jemand Inhalte gesehen, die er nicht sehen durfte? Das Ziel ist null |
| Resistenz gegen Prompt Injection | Können Anweisungen, die in einer Nachricht, E-Mail oder einem Dokument versteckt sind, das Verhalten des Agenten ändern? Das nennt man indirekte Prompt Injection |
| Eingabegenauigkeit | Hat er Dokumente, Formulare und Nachrichten korrekt gelesen und, wo Sprache genutzt wird, Gesprochenes korrekt verstanden? |
| Antwortgenauigkeit | Nutzt seine Antwort oder Zusammenfassung nur, was in der Quelle steht, ohne Erfundenes und ohne dass Wichtiges fehlt? |
| Kosten | Was hat die Arbeit bei jedem Produkt gekostet, in Tokens und in Geld? Entnommen aus der Abrechnung des jeweiligen Produkts |
Nicht sicher, welche Metriken am wichtigsten sind?
Ein Engineer zeigt Ihnen, was Sie für Ihren Agententyp messen sollten. Mit einem Engineer sprechen.
Arbeitsweise
Automatisierte und manuelle Tests, wiederholbar und gegen die richtige Antwort geprüft
Jeder Test erreicht beide Produkte jedes Mal auf genau dieselbe Weise. Das erfordert Automatisierung, mit manuellen Schritten nur dort, wo ein Produkt sie verlangt.
- 1
Automatisiert auf beiden Produkten
Beide Produkte werden per Testautomatisierung gesteuert, ob sie im Browser, in einer Desktop-App oder in einem Chatfenster laufen, sodass jedes in jedem Durchlauf exakt dieselbe Eingabe erhält.
- 2
Snapshots vorher und nachher
Wir erfassen den Zustand jedes verbundenen Tools vor und nach jedem Durchlauf und vergleichen beide automatisch.
- 3
Gegen die richtige Antwort geprüft
Jede Ausgabe wird mit der vorab festgelegten korrekten Antwort verglichen. Datensätze werden im Tool geprüft, Zahlen unabhängig nachgerechnet, und Texte bewertet ein KI-Modell nach dem Verfahren LLM-as-a-judge. Für Meeting-Inhalte übernimmt das unser eigenes Tool MOSAIC in großem Maßstab.
- 4
Reproduzierbare Bewertungen
Die Bewertungsanweisungen für jede Metrik stehen unter Versionskontrolle, sodass sich jede Bewertung reproduzieren oder später neu berechnen lässt, wenn sich eine Metrik ändert.
- 5
Viele Wiederholungen statt eines Durchlaufs
Jede Aufgabe läuft mehrmals, und die Bewertung erfolgt in Batches von Tausenden, sodass wir wissen, wie konsistent der Agent ist, statt zu raten.
Unser Vorgehen
Vom Umfang zum Bericht in vier Schritten
Unsere Services für KI-Agenten-Benchmarking folgen vier Schritten, wobei Ihr Team am Anfang und am Ende eingebunden ist.
Umfang
Wir legen gemeinsam mit Ihnen den Wettbewerber, die Aufgaben und die Metriken fest.
Einrichtung
Wir richten beide Produkte ein, laden identische Inhalte und legen die korrekten Antworten fest.
Durchläufe
Automatisierte Durchläufe auf beiden Produkten, wiederholt und im Parity Ledger protokolliert.
Bericht
Ergebnisse, das Evidence Pack und eine gemeinsame Besprechung mit Ihrem Team.
Erfahren Sie, wo Ihr KI-Agent steht
Nennen Sie den Wettbewerber und die Aufgaben, die zählen. Wir bauen einen fairen, wiederholbaren Benchmark und liefern Ihnen Ergebnisse, auf deren Basis Sie handeln und die Sie veröffentlichen können.
Beispiele
Echte Aufgaben, die wir testen
Wir bauen jeden Benchmark um die Aufgaben herum, die Ihr eigener Agent übernimmt. Diese Beispiele zeigen, welche Art von Arbeit wir in verschiedenen Branchen testen.
Kundenanfrage von Anfang bis Ende
Der Agent liest ein Support-Ticket, aktualisiert den Kundendatensatz, prüft Bestell- und Abrechnungsstatus und entwirft eine Antwort.
Terminänderung
Ein Patient möchte einen Termin verschieben. Der Agent findet einen neuen Termin, aktualisiert die Buchung und bestätigt sie, ohne Daten anderer Patienten preiszugeben.
Frage mit eingeschränktem Zugriff
Ein Mitarbeiter fragt etwas, dessen beste Antwort in Inhalten steht, die er nicht sehen darf.
Zahlungsreklamation
Ein Kunde reklamiert eine Kartenzahlung. Der Agent prüft die Transaktion, wendet die Richtlinie der Bank an, aktualisiert das Konto und bestätigt das Ergebnis.
Vom Meeting zum Ticket
Ein Gespräch findet statt. Der Agent schreibt Notizen, Entscheidungen und Aufgaben auf, legt die Tickets an und gibt die Links zurück.
Vom Dokument zum Bericht
Aus einem Vertrag und einer Projektspezifikation werden eine kurze Zusammenfassung und ein Statusbericht.
Das Ergebnis
Ein Bericht und die Belege dahinter
Der Bericht liefert Ihnen die Ergebnisse. Mit dem Evidence Pack kann jeder sie überprüfen, und genau deshalb können Sie die Ergebnisse bedenkenlos veröffentlichen.
Im Bericht
- Ergebnisse für jede Metrik, mit dem Aufbau, unter dem sie getestet wurde
- Ergebnisse für jede Aufgabe, mit der Ausgabe und den Änderungen im Tool, die sie belegen
- Jede Funktion, die bei einem der Produkte nicht getestet werden konnte, und der Grund dafür
- Stellen, an denen die Dokumentation eines Anbieters das eine sagt und das Produkt etwas anderes tut
Im Evidence Pack
- Das Parity Ledger für jeden Testdurchlauf
- Alle Testinhalte und die korrekten Antworten, anhand derer jedes Ergebnis bewertet wurde
- Jede Rohausgabe, gespeichert, damit Metriken später neu bewertet werden können, ohne die Tests erneut auszuführen
Sehen Sie, wie die Belege aussehen
Erhalten Sie einen Beispielbericht und ein Parity Ledger aus einem früheren Benchmark. Beispielbericht anfordern.
Partner werden von TestDevLab
Benchmarks, die standhalten
„Wenn jemandem ein Benchmark-Ergebnis nicht gefällt, stellt er als Erstes die Methode infrage. Deshalb lassen wir beide Agenten mit demselben Tarif, denselben Inhalten und unter denselben Bedingungen laufen, protokollieren jeden Durchlauf im Parity Ledger und prüfen die Tools, in denen jeder Agent gearbeitet hat, nicht nur seine Antwort. Unsere Ergebnisse halten stand, weil die Methode standhält.“

Direktorin für High-Tech-Innovation und Testing Operations
- 500+
- erfahrene QA-Experten
- 5000+
- echte Geräte
- 14
- Jahre im QA-Geschäft
- 95,6 %
- Kundenbindung
Die Grundlagen
Was ist KI-Agenten-Benchmarking?
KI-Agenten-Benchmarking bedeutet, zwei oder mehr KI-Agenten unter denselben Bedingungen dieselben Aufgaben zu geben und dann in den Tools, in denen jeder Agent gearbeitet hat, zu prüfen, was er tatsächlich getan hat. Es liefert vergleichbare Ergebnisse zu Aufgabenerfüllung, Zuverlässigkeit, Datengenauigkeit, Zugriffskontrolle, Resistenz gegen Prompt Injection und Kosten.
Es ist Teil unserer KI-Testservices, zu denen auch unsere KI-Chatbot-Tests und -Evaluierung gehören.
Im Vergleich zur Modellevaluierung
Die Modellevaluierung bewertet die Antworten eines Modells anhand eines Testdatensatzes. KI-Agenten-Benchmarking prüft, was der Agent in echten Tools tatsächlich getan hat, einschließlich korrekter Arbeit an der falschen Stelle.
Im Vergleich zum Agenten-Monitoring
Monitoring, oft auch Observability genannt, zeigt, was Ihr eigener Agent in der Produktion tut. Benchmarking zeigt, wie er bei derselben Aufgabe im Vergleich zum Agenten eines Wettbewerbers abschneidet, und das können Ihnen Ihre eigenen Daten nicht sagen.
FAQ
Antworten auf die häufigsten Fragen
KI-Agenten-Benchmarking vergleicht zwei oder mehr KI-Agenten bei denselben Aufgaben unter identischen Bedingungen und prüft, was jeder davon in den genutzten Tools tatsächlich getan hat.
Für jede Branche, in der ein KI-Agent Informationen liest und in Business-Tools handelt, darunter Banken und Finanzen, Gesundheitswesen, Kundensupport, Reisen, IT, Vertrieb und Produktivität am Arbeitsplatz. Wir bauen die Testaufgaben um das herum, was Ihr eigener Agent tut.
Ja. Wir prüfen, ob der Agent Gesprochenes korrekt versteht und danach handelt, zusätzlich zu denselben Aufgaben- und Zugriffsprüfungen.
Die Evaluierung von KI-Agenten bewertet meist die Antworten eines einzelnen Agenten, oft mit einem Framework, das Ihr eigenes Team betreibt. Benchmarking vergleicht zwei Produkte unter identischen, dokumentierten Bedingungen und prüft die Ergebnisse in den Tools, in denen sie gearbeitet haben. Erst das macht die Ergebnisse für einen öffentlichen Vergleich verwendbar.
Standardtests prüfen, ob die Antwort des Agenten richtig aussieht. Ein Agent kann eine korrekt wirkende Antwort geben und trotzdem falsche Daten eintragen, den falschen Datensatz aktualisieren, Inhalte jemandem zeigen, der sie nicht sehen darf, oder einer in einem Dokument versteckten Anweisung folgen. Solche Probleme finden Sie nur, wenn Sie die verbundenen Tools prüfen.
Wir geben dem Agenten echte Aufgaben in den Tools, in denen er arbeitet, führen jede Aufgabe mehrmals vom selben Ausgangspunkt aus und prüfen die Tools vor und nach jedem Durchlauf. Die Ausgaben werden mit vorab festgelegten korrekten Antworten verglichen, sodass wir messen, was der Agent tatsächlich getan hat, nicht nur, was er gesagt hat.
Beide Produkte laufen mit demselben Abonnement, denselben aus einer Quelle geladenen Inhalten, denselben Anfragen, derselben Hardware und demselben Netzwerk sowie einem gemeinsamen Satz an Business-Tools. Jeder Durchlauf wird im Parity Ledger protokolliert, das Versionen, Tarif, Einstellungen und den ausführenden Testnutzer festhält.
Ja. Wir testen auf indirekte Prompt Injection, bei der Anweisungen in Inhalten versteckt sind, die der Agent liest. Wir prüfen das in Kundennachrichten, E-Mails, geteilten Dokumenten, Kalendereinladungen, Chats und verbundenen Datensätzen.
Jeder Fall, in dem Inhalte einen Testnutzer erreichen, der sie nicht sehen darf, ob in der Antwort, einer Quellenangabe, einer Vorschau, einer generierten Datei oder im Aktivitätsprotokoll des Agenten. Das Ziel ist null, deshalb weisen wir die genaue Anzahl aus, keinen Prozentsatz.
Wir führen dieselbe Aufgabe mehrmals vom selben Ausgangspunkt aus, setzen zwischen den Versuchen alles zurück und weisen aus, wie oft sie gelingt. Dieses Maß ist als pass@k bekannt.
Ja, genau dafür ist das Evidence Pack da. Zu jedem Ergebnis gehören das Parity Ledger, die Testinhalte und die korrekten Antworten, anhand derer es bewertet wurde, sodass jeder es überprüfen kann.
Wir weisen sie aus und erklären, warum sie beim anderen Produkt nicht getestet werden konnte. Eine fehlende Funktion ist für sich genommen schon ein nützlicher Befund.
Zwei sind der Standardvergleich, weil sich identische Bedingungen bei einem Paar am einfachsten und zuverlässigsten herstellen lassen. Weitere Produkte können im Einzelfall hinzukommen.
Nach jedem wesentlichen Update Ihres Agenten oder der Modelle und Integrationen, auf die er angewiesen ist, und vor größeren Vertriebs- oder Sicherheitsprüfungen. Viele Teams führen außerdem jedes Quartal einen Benchmark durch, weil sich Wettbewerber und zugrunde liegende Modelle von selbst verändern.
Wenn Sie Ihren eigenen Agenten benchmarken: Admin-Zugang zu Ihrem Workspace, den Wettbewerber, mit dem Sie sich vergleichen möchten, und die Aufgaben, die für Ihr Geschäft am wichtigsten sind. Wenn Sie zwischen Anbietern wählen: Test- oder Pilotzugang zu jedem Produkt und die Aufgaben, für die Sie sie einsetzen würden. In beiden Fällen richten wir die Produkte ein, erstellen die Testinhalte und legen die korrekten Antworten fest.