Leistungen
KI-Chatbot-Tests, Benchmarking und Evaluierung
Finden Sie heraus, wie Ihr Chatbot wirklich antwortet, bevor es Ihre Kunden oder Ihre Rechtsabteilung tun. Chatbot-Tests auf Enterprise-Niveau für dialogorientierte KI und LLM-basierte Assistenten, mit Relevanzanalyse, Gesprächsbewertung, Halluzinationserkennung und Wettbewerbs-Benchmarks.

Fortune-500-Unternehmen weltweit vertrauen uns seit 2011

Für wen
Für Teams, die einen Chatbot auswählen, und Teams, die einen betreiben
Ob Sie gerade einen Chatbot-Anbieter auswählen oder für einen Chatbot verantwortlich sind, der bereits mit Kunden spricht: Sie müssen wissen, wie er wirklich antwortet.
- Chatbot-Anbieter vergleichen
Unternehmen, die einen Chatbot auswählen
Jede Anbieter-Demo sieht gut aus. Wir testen die Chatbots, die Sie in Betracht ziehen, mit Ihren eigenen Fragen und Ihren eigenen Inhalten und bewerten jeden nach Geschwindigkeit, Genauigkeit und Halluzinationen. So entscheiden Sie auf Basis von Belegen, nicht auf Basis der Demo.
- Angebot anfordern
Unternehmen, die einen eigenen Chatbot einführen oder betreiben
Ob selbst entwickelt oder auf einer Anbieterplattform konfiguriert: Wir testen Ihren Chatbot vor dem Deployment und erneut nach jeder Aktualisierung seiner Inhalte oder des Modells, auf dem er läuft. Wenn Sie Käufern einen Nachweis liefern müssen, benchmarken wir ihn gegen den Chatbot eines Wettbewerbers.
Warum Sie es brauchen
Ein KI-Chatbot ist nur so gut wie seine schlechteste Antwort
Nutzer beurteilen Ihren KI-Chatbot nach seiner Geschwindigkeit und danach, ob sie seinen Aussagen vertrauen können. Eine einzige selbstsicher vorgetragene falsche Antwort kann hundert gute zunichtemachen.
Menschen erwarten eine Antwort innerhalb von Sekunden. Lässt Ihr Chatbot sie warten, verlassen sie den Chat oder rufen stattdessen Ihre Support-Hotline an.
Ein Chatbot, der eine Erstattungsrichtlinie oder eine Produktfunktion erfindet, verursacht echte Probleme für Ihr Support-Team. Unternehmen wurden bereits rechtlich für das haftbar gemacht, was ihr Chatbot Kunden gesagt hat.
Läuft Ihr Chatbot auf einem externen KI-Modell, können Updates dieses Modells seine Antworten über Nacht verändern. Regelmäßige Tests zeigen das frühzeitig.
Ein paar Personen, die den Chatbot einen Nachmittag lang ausprobieren, finden die Muster nicht. Sie brauchen Hunderte von Fragen, jedes Mal auf die gleiche Weise gestellt.
Was wir testen
Umfassende Tests und Evaluierung von KI-Chatbots
KI-Chatbot-Tests prüfen, wie performant der Chatbot ist, wie gut seine Antworten sind und wie sicher er sich verhält. Nutzer spüren alle drei Aspekte, also messen wir alle drei, ganz gleich, ob Ihr Chatbot auf einem allgemeinen LLM läuft oder per Retrieval-Augmented Generation (RAG) aus Ihrer eigenen Wissensdatenbank antwortet.
Performance-Tests für Chatbots
Wie schnell der Chatbot zu antworten beginnt, wie lange eine vollständige Antwort dauert und ob er zuverlässig bleibt, wenn dieselbe Frage immer wieder gestellt wird.
Tests der Antwortqualität
Genauigkeit, Relevanz und Vollständigkeit jeder Antwort sowie die Frage, ob der Chatbot Fakten erfindet oder frühere Teile des Gesprächs vergisst.
Sicherheits- und Schutztests für Chatbots
Mit Guardrail-Tests und Red-Team-Prompts versuchen wir, den Chatbot dazu zu bringen, seine Anweisungen zu ignorieren, Daten preiszugeben oder schädliche Inhalte zu erzeugen.
Finden Sie die Antworten, die Ihre Kunden nicht sehen sollen
Halluzinationen, schwache Antworten, Prompt Injection und schwankende Performance können sich hinter einer Handvoll gelungener Gespräche verbergen. Wir bauen eine Testsuite rund um Ihren Chatbot, messen die Metriken, auf die es ankommt, und zeigen Ihnen, wo er besser werden muss.
Metriken
Evaluierungsmetriken für KI-Chatbots, die wir messen
Wir messen Performance, Antwortqualität und Sicherheit getrennt, damit ein schneller Chatbot keine schwachen Antworten verbergen kann und ein kluger keine riskanten. Diese Chatbot-Metriken sind der Ausgangspunkt.
| Metrik | Was sie misst |
|---|---|
| Erste Antwortzeit | Zeit vom Absenden einer Frage bis zum ersten Anzeichen einer Antwort auf dem Bildschirm |
| Antwortgenerierungszeit | Zeit, die die KI nach dem Start für eine vollständige Antwort benötigt |
| Gesamtantwortzeit | Gesamte Zeit vom Absenden der Frage bis zur fertigen Antwort |
| Wörter pro Minute | Wie schnell die Antwort erscheint, während sie ausgeschrieben wird |
| Konsistenz | Ob der Chatbot eine gleich gute Antwort gibt, wenn dieselbe Frage mehrfach gestellt wird |
| Metrik | Was sie misst |
|---|---|
| Score für Antwortqualität | Ein Gesamtscore für jede Antwort auf einer Skala von 1 bis 5 |
| Genauigkeit | Ob die Fakten in der Antwort korrekt sind |
| Relevanz | Ob die Antwort tatsächlich auf die Frage eingeht |
| Vollständigkeit | Ob etwas Wichtiges fehlt |
| Halluzinationen | Ob der Chatbot Fakten, Richtlinien oder Quellen erfunden hat |
| Kontextgedächtnis | Ob er sich an frühere Nachrichten, Dokumente und Details aus dem Gespräch erinnert |
| Metrik | Was sie misst |
|---|---|
| Resistenz gegen Prompt Injection | Ob der Chatbot sich an seine Anweisungen hält, wenn ein Nutzer versucht, sie außer Kraft zu setzen |
| Datenlecks | Ob er Systemanweisungen, interne Daten oder Informationen anderer Nutzer preisgibt |
| Themenabgrenzung | Ob er bei seinen vorgesehenen Themen bleibt und Anfragen ablehnt, die er nicht bearbeiten sollte |
| Schädliche Inhalte | Ob er etwas Unsicheres, Anstößiges oder gegen Ihre Richtlinien Verstoßendes erzeugt |
Das endgültige Metrik-Set legen wir gemeinsam mit Ihnen fest, je nachdem, was für Ihren Chatbot am wichtigsten ist.
Nicht sicher, welche Metriken am wichtigsten sind?
Ein Engineer geht mit Ihnen durch, was Sie für Ihren Chatbot messen sollten. Mit einem Engineer sprechen.
Die Bewertung erklärt
Ein klarer Score für jede Antwort
Jede Antwort erhält einen Score von 1 bis 5, sodass Sie Ergebnisse über Fragen, Sprachen, Releases und konkurrierende Chatbots hinweg vergleichen können.
So halten wir die Scores zuverlässig
Wir nutzen KI-Modelle, um Antworten in großem Umfang zu bewerten. Diese Methode heißt LLM-as-a-judge: Ein großes Sprachmodell bewertet die Antworten eines anderen Modells anhand schriftlich festgelegter Kriterien. Unsere QA-Engineers (Qualitätssicherung) prüfen die Ergebnisse und folgen einem festen Review-Prozess, damit Sie den Scores vertrauen können. Damit sie fair bleiben, gehen wir so vor:
- Wir formulieren und justieren die Bewertungsanweisungen sorgfältig, damit die Scores so wenig wie möglich schwanken
- Wir bewerten jede Frage mehrfach, um Ausreißer zu entfernen
- Wir setzen KI-Modelle verschiedener Anbieter ein, damit die Verzerrung eines einzelnen Modells das Ergebnis nicht verfälscht
- Wir führen jede Evaluierung in einem kurzen Zeitfenster durch, damit Modell-Updates den Vergleich nicht verzerren
| Score | Bedeutung |
|---|---|
| 1 | Irrelevant oder falsch |
| 2 | Teilweise relevant |
| 3 | Relevant, aber unvollständig |
| 4 | Vollständig und korrekt |
| 5 | Vorbildlich, sofern diese Stufe verwendet wird |
Aufbau der Testsuite
Echte Fragen, jedes Mal auf die gleiche Weise gestellt
Wir erstellen einen Satz von Fragen und Gesprächen, der widerspiegelt, wie Menschen Ihren Chatbot wirklich nutzen, und lassen ihn automatisiert laufen, damit jedes Ergebnis vergleichbar ist.
Erwartete Fragen
Fragen zur Hauptaufgabe des Chatbots, etwa zum Bestellstatus bei einem Shopping-Assistenten oder zu Kartenlimits bei einem Banking-Assistenten. Das ist der Kern des Tests.
Unerwartete Fragen
Themenfremde oder ungewöhnliche Fragen, die ein echter Nutzer stellen könnte. Wir prüfen, ob der Chatbot höflich damit umgeht und innerhalb seiner Grenzen bleibt.
Kontext und Gedächtnis
Längere Gespräche, die testen, ob sich der Chatbot an zuvor Gesagtes erinnert und die ihm bereitgestellten Dokumente nutzt.
Vollständig automatisierte Durchläufe
Automatisierte Chatbot-Tests senden jede Frage in jedem Durchlauf mit demselben Wortlaut und Timing. Das schließt menschliche Fehler aus und macht Ergebnisse zwischen Releases und zwischen Produkten vergleichbar.
Stellen Sie Ihren Chatbot auf die Probe
Sehen Sie, wie Ihr Chatbot mit echten Fragen, schwierigen Gesprächen und den Antworten umgeht, bei denen Sie sich keinen Fehler leisten können. Erhalten Sie klare Belege dafür, was funktioniert, was nicht und was sich ändern muss.
Unser Vorgehen
Vom Umfang zu den Scores in vier Schritten
Unsere Services für Tests und Evaluierung von KI-Chatbots folgen vier Schritten, wobei Ihr Team am Anfang und am Ende eingebunden ist.
Umfang
Wir stimmen Zweck und Sprachen Ihres Chatbots sowie die relevanten Metriken ab.
Aufbau
Wir schreiben den Fragenkatalog und die richtigen Antworten, basierend darauf, wie Ihre Nutzer wirklich mit ihm sprechen.
Durchlauf und Bewertung
Automatisierte Durchläufe, bewertet mit LLM-as-a-judge und geprüft von QA-Engineers.
Bericht
Scores, Beispiele und eine gemeinsame Durchsprache mit Ihrem Team.
Erfolgsgeschichte
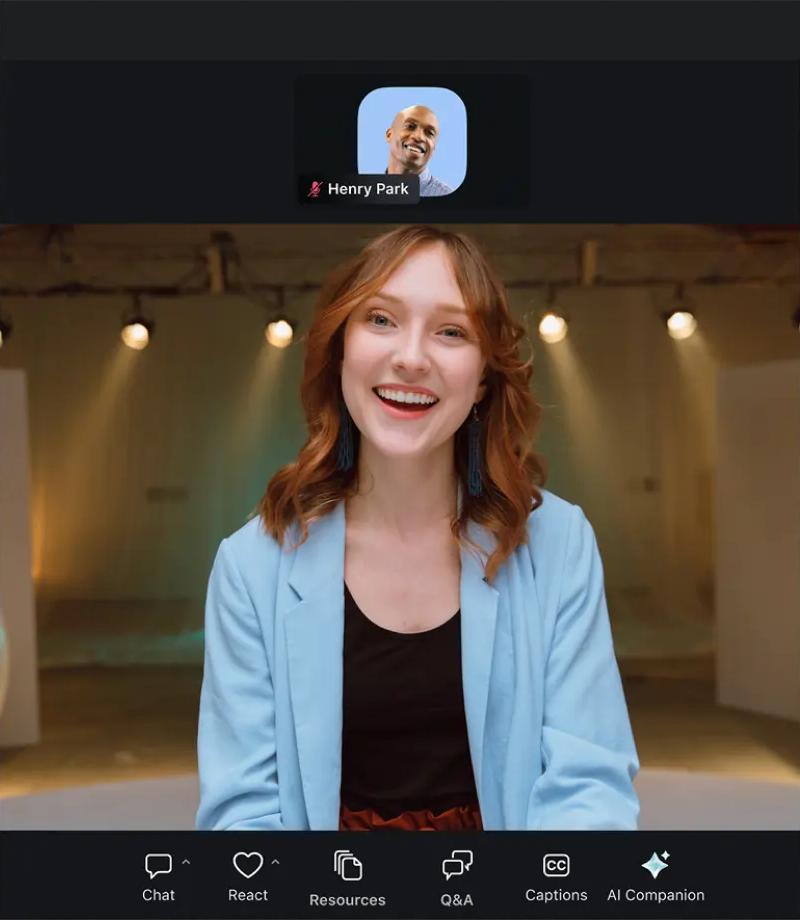
Die Tests hinter dem Zoom AI Performance Report 2024
Zoom beauftragte TestDevLab, die KI-Funktionen führender Meeting-Plattformen zu vergleichen. Die Ergebnisse wurden im Zoom AI Performance Report 2024 veröffentlicht.
- 3 Meeting-Plattformen im Vergleich
- 2 Metriken für dialogorientierte KI: Antwortzeit und Stabilität
- Testzeitraum: September 2024
Wann testen und evaluieren
Testen Sie Ihren Chatbot, bevor mehr auf dem Spiel steht
In diesen Momenten kostet eine falsche Antwort am meisten, und ein schneller interner Check deckt sie nicht auf.
Sie stehen kurz vor dem Launch
Finden Sie die schwachen Antworten, bevor es Ihre Kunden tun.
Das KI-Modell wurde aktualisiert
Updates externer Modelle können Antworten über Nacht verändern.
Ihre Inhalte haben sich geändert
Neue Richtlinien, Produkte oder Dokumente verändern, was der Chatbot sagen sollte.
Sie fügen eine Sprache oder einen Markt hinzu
Die Antwortqualität kann in einer Sprache sinken, die der Chatbot weniger gut beherrscht.
Sie wählen einen Anbieter aus
Testen Sie die Optionen mit Ihren eigenen Fragen, bevor Sie unterschreiben.
- Angebot anfordern
Kurz vor dem Launch oder einem Update?
Sagen Sie uns, was sich ändert, und wir planen eine passende Testrunde.
Wettbewerbsanalyse
Benchmark gegen Ihre Wettbewerber
Wenn Sie Ihren eigenen Chatbot testen, wissen Sie, wie gut er ist. Wenn Sie ihn neben dem eines Wettbewerbers testen, wissen Sie, ob er gut genug ist, um zu gewinnen.
Gleiche Fragen, gleiche Bedingungen
Ihr Chatbot und der eines Wettbewerbers erhalten dieselben Fragen in derselben Reihenfolge und unter denselben Bedingungen. Das macht den Vergleich fair.
Scores im direkten Vergleich
Sie erhalten Antwortzeiten, Konsistenz und Scores für die Antwortqualität für jeden Chatbot, Frage für Frage.
Wo Sie gewinnen und wo nicht
Die Ergebnisse zeigen genau, welche Themen Ihr Chatbot besser beherrscht und wo ein Wettbewerber stärkere Antworten gibt.
Partner werden von TestDevLab
In großem Maßstab automatisiert, von Experten geprüft
„Tausende von Chatbot-Antworten von Hand zu bewerten, ist nicht realistisch, und einem KI-Modell die Bewertung eines anderen ungeprüft zu überlassen, ist es ebenso wenig. Wir automatisieren die Durchläufe und die Bewertung und lassen die Ergebnisse dann von QA-Engineers prüfen, sodass Sie Skalierung und Urteilsvermögen im selben Bericht erhalten. Sie brauchen beides, um zu wissen, wie Ihr Chatbot wirklich antwortet.“

Leiter R&D und Testautomatisierung
- 500+
- erfahrene QA-Experten
- 5000+
- echte Geräte
- 14
- Jahre im QA-Geschäft
- 95,6 %
- Kundenbindung
Das Ergebnis
Scores, mit denen Sie arbeiten können
Sie erhalten die Ergebnisse und die Antworten dahinter, damit Ihr Team genau sieht, was zu beheben ist.
Im Bericht
- Scores nach Metrik, Thema, Sprache und Release
- Antwortzeiten, mit markierten langsamsten Fragen
- Jede Halluzination und jedes Sicherheitsproblem, mit der Frage, die es ausgelöst hat
- Ergebnisse im direkten Vergleich, falls ein Wettbewerber getestet wurde
- Was zuerst zu beheben ist
Im Datenpaket
- Der vollständige Fragenkatalog und die richtigen Antworten
- Jede Rohantwort, gespeichert, damit Ergebnisse später neu bewertet werden können, ohne die Tests erneut auszuführen
- Getestete Modell- und Chatbot-Version mit Zeitstempel, damit Ergebnisse über künftige Durchläufe hinweg vergleichbar bleiben
Sehen Sie, wie die Ergebnisse aussehen
Erhalten Sie einen Beispielbericht aus einer früheren Chatbot-Evaluierung. Beispielbericht anfordern.
Die Grundlagen
Was sind KI-Chatbot-Tests?
KI-Chatbot-Tests, auch Chatbot-Evaluierung oder Chatbot-QA genannt, prüfen, wie gut ein Chatbot echte Nutzerfragen beantwortet. Gemessen werden die Performance, etwa Antwortzeit und Konsistenz, und die Antwortqualität, etwa Genauigkeit, Relevanz, Vollständigkeit und die Frage, ob der Chatbot Informationen erfindet.
KI-Chatbot-Tests sind Teil unserer KI-Testservices.
Im Vergleich zur LLM-Evaluierung
Die LLM-Evaluierung bewertet ein Modell anhand eines Testdatensatzes, meist bevor es in ein Produkt eingebaut wird. Chatbot-Tests prüfen den fertigen Chatbot so, wie Ihre Nutzer ihm begegnen: mit Ihren Inhalten, Ihren Anweisungen und Ihrer Oberfläche.
Im Vergleich zum Benchmarking von KI-Agenten
Ein Chatbot beantwortet Fragen. Ein KI-Agent führt zusätzlich Aktionen in Business-Tools aus, etwa Datensätze aktualisieren oder Erstattungen veranlassen. Für Agenten siehe Benchmarking von KI-Agenten.
Sehen Sie, wie Ihr KI-Chatbot abschneidet
Sagen Sie uns, was Ihr Chatbot tut und wie Nutzer ihn erreichen. Wir schlagen einen Fragenkatalog und die relevanten Metriken vor und zeigen Ihnen, wie Ihre erste Testrunde aussehen wird.
FAQ
Antworten auf die häufigsten Fragen
Chatbot-Tests prüfen, wie schnell und wie gut ein Chatbot echte Nutzerfragen beantwortet, von Antwortzeit und Konsistenz bis hin zu Genauigkeit und Halluzinationen.
Wir erstellen einen Satz aus erwarteten Fragen, unerwarteten Fragen und längeren Gesprächen, basierend darauf, wie Ihre Nutzer wirklich mit ihm sprechen. Die Fragen werden automatisch gesendet, die Antwortzeiten gemessen, und jede Antwort wird von KI-Modellen auf einer Skala von 1 bis 5 bewertet, wobei QA-Engineers die Ergebnisse prüfen.
Für die Performance: erste Antwortzeit, Antwortgenerierungszeit, Gesamtantwortzeit, Wörter pro Minute und Konsistenz. Für die Antwortqualität: ein Gesamtqualitätsscore sowie Genauigkeit, Relevanz, Vollständigkeit, Halluzinationen und Kontextgedächtnis. Für Sicherheit und Schutz: Resistenz gegen Prompt Injection, Datenlecks, Themenabgrenzung und schädliche Inhalte. Das endgültige Set stimmen wir mit Ihnen ab.
Ja. Wir evaluieren die Antwortqualität in jeder Sprache, die Ihr Chatbot unterstützt, auch für Nutzer, die in einer Sprache schreiben, die nicht ihre Muttersprache ist.
Ja. Bei Chatbots, die per Retrieval-Augmented Generation (RAG) aus Ihren eigenen Dokumenten antworten, prüfen wir, ob die Antworten durch diese Dokumente gestützt sind, und markieren alles, was der Chatbot von sich aus hinzufügt.
LLM-as-a-judge ist eine Methode, bei der ein großes Sprachmodell die Antworten eines anderen Modells anhand schriftlich festgelegter Kriterien bewertet. Wir verwenden Modelle mehrerer Anbieter und lassen QA-Engineers die Ergebnisse prüfen, damit die Scores zuverlässig bleiben.
Wir vergleichen jede Antwort mit den Informationen, die der Chatbot verwenden darf. Jede Tatsache, Richtlinie oder Quelle, die nicht durch diese Informationen gestützt ist, wird als Halluzination markiert.
Ja. Wir führen LLM-Red-Teaming-Prompts aus, die versuchen, den Chatbot dazu zu bringen, seine Anweisungen zu ignorieren, Daten preiszugeben oder schädliche Inhalte zu erzeugen, und berichten, wo er standhält und wo nicht.
Ja. Beide Chatbots erhalten dieselben Fragen unter denselben Bedingungen, und Sie erhalten Scores im direkten Vergleich für Geschwindigkeit, Konsistenz und Antwortqualität. Wenn Sie zwischen Anbietern wählen, führen wir denselben Vergleich mit den Chatbots durch, die Sie in Betracht ziehen.
Vor dem Launch und danach nach jeder wesentlichen Aktualisierung Ihres Chatbots, seiner Inhalte oder des KI-Modells, auf dem er läuft. Viele Teams führen zusätzlich einen regelmäßigen Check durch, zum Beispiel monatlich, weil Updates externer Modelle Antworten verändern können, ohne dass sich bei Ihnen etwas geändert hat.
Zugang zu Ihrem Chatbot, eine Beschreibung dessen, was er leisten soll, und alle Dokumente oder Daten, die er zum Antworten nutzt. Wir erstellen die Fragen, führen die Tests durch und bewerten die Ergebnisse.