Servicios
Benchmarking de agentes de IA
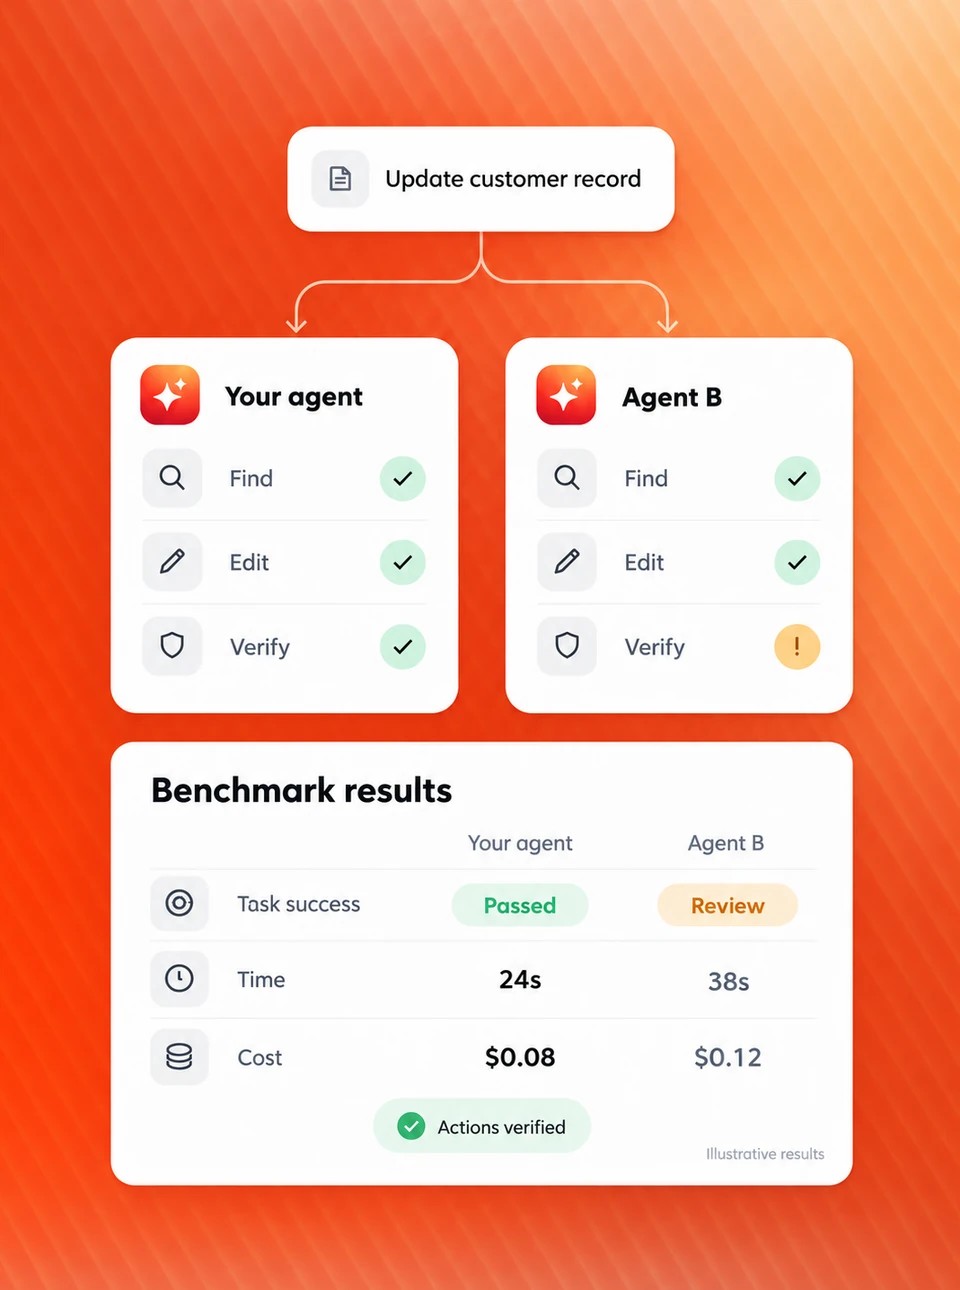
Sometemos su agente de IA y un producto de la competencia al mismo trabajo real. Después revisamos por dentro las herramientas en las que trabajó cada agente para ver qué hizo realmente. Usted obtiene cifras claras de precisión, fiabilidad, seguridad y coste.
Empresas Fortune 500 de todo el mundo confían en nosotros desde 2011

Por qué importa
Su agente puede cambiar sin que usted lo toque
El mercado de agentes de IA cambia cada pocos meses. Los benchmarks periódicos muestran cuáles de sus ventajas siguen siendo reales y dónde le ha alcanzado un competidor.
Los modelos e integraciones de los que depende su agente se actualizan constantemente. Un agente que funcionaba bien el mes pasado puede comportarse de otra forma hoy, y repetir la prueba lo detecta a tiempo.
Una función que le diferenciaba hace seis meses puede ser hoy algo que ofrece cualquier competidor. El benchmarking le indica cuáles de sus puntos fuertes se mantienen.
Todos los proveedores afirman que su agente es preciso y seguro. Los resultados independientes dan a los compradores una base sólida para comparar y a su equipo comercial pruebas que compartir.
Las pruebas públicas que comparan agentes de IA suelen evaluar cada producto de una forma distinta, así que sus resultados dicen muy poco. Nosotros aplicamos un único método a ambos productos.
A quién va dirigido
Para equipos que eligen un agente de IA y equipos que lo desarrollan
Tanto si compra un agente como si lo lanza al mercado, necesita evidencia que se sostenga fuera de su propio equipo.
- Comparar agentes de IA
Empresas que eligen entre agentes de IA
Todos los proveedores afirman que su agente es preciso y seguro. Comparamos agentes de IA con sus propias tareas, en sus propias herramientas, y mostramos cuál completa realmente el trabajo sin introducir datos erróneos ni filtrar accesos. Utilice los resultados en compras, revisiones de seguridad y decisiones sobre proyectos piloto.
- Solicitar un presupuesto
Empresas que desarrollan su propio agente de IA
Necesita saber cómo rinde su agente y cómo se sitúa frente a la competencia. Probamos su agente por sí solo antes del lanzamiento o tras una actualización del modelo, y lo comparamos cara a cara cuando necesita pruebas para sus compradores.
Lo que obtiene
Resultados útiles para todos sus equipos
Nuestros servicios de benchmarking de agentes de IA dan a su equipo de producto datos claros sobre la calidad y a su equipo comercial pruebas que puede presentar a los compradores. Si está eligiendo entre agentes, obtiene la misma evidencia para su decisión de proveedor y su revisión de seguridad.
Para su equipo de producto
Dónde se encuentra hoy
Cómo rinde su agente frente a la competencia en las mismas tareas, actualizado en cada ciclo de pruebas.
Alerta temprana cuando baja la calidad
Cuando cambia un modelo o una integración subyacente, la siguiente ejecución muestra qué ha empeorado y en qué medida.
Respuestas para las revisiones de seguridad
Resultados claros sobre datos erróneos, fugas de acceso e inyección de prompts, las tres cuestiones por las que más preguntan los compradores empresariales.




Para su equipo comercial
Resultados que puede publicar
Cada resultado incluye un registro de cómo se configuró la prueba, para que los clientes puedan comprobarlo por sí mismos.
Pruebas que respaldan sus afirmaciones
Evidencia de los puntos concretos de los que depende su argumentario de ventas, actualizada a medida que evoluciona el mercado.
Un aviso cuando un competidor se adelanta
Lo sabrá mientras aún tiene tiempo de responder en su próxima release.
Descubra cómo rinde realmente su agente de IA
Obtenga evidencia clara de precisión, fiabilidad y seguridad en las tareas que importan a su equipo.
Qué evaluamos
Descubra dónde falla la calidad de su agente de IA
La calidad de un agente tiene al menos cinco componentes, y cada uno puede fallar por separado. Un agente puede tomar unas notas de reunión perfectas y aun así actualizar el registro de cliente equivocado.
Comprensión de la entrada
¿Lee correctamente documentos, mensajes, formularios, datos y voz, y utiliza solo lo que realmente contienen?
Finalización de tareas
¿Completa el trabajo correctamente en las herramientas en las que opera? Revisamos las propias herramientas, no solo la respuesta del agente.
Fiabilidad y velocidad
¿Resuelve bien la misma tarea cada vez, y cuánto tiempo tiene que esperar el usuario?
Seguridad y cumplimiento
¿Respeta los permisos de acceso, ignora las instrucciones ocultas y trata los datos sensibles como exige la normativa de su sector?
Facilidad de uso
¿Cuánto esfuerzo le cuesta al usuario obtener un resultado útil? Medido de forma objetiva.
- Solicitar un presupuesto
¿Tiene un proyecto en mente?
Cuéntenos qué tiene previsto. Le ayudaremos a dar el siguiente paso.
Cuándo lo necesita
Haga benchmarking de su agente de IA antes de que haya más en juego
La mayoría de los equipos acuden a nosotros cuando está a punto de decidirse algo: un contrato, una revisión, un lanzamiento. Cada uno de estos momentos exige evidencia independiente, ajena a su propio equipo.
Los compradores empresariales quieren saber cómo gestiona su agente los permisos de acceso y las instrucciones ocultas. Nuestros resultados les dan cifras que revisar, no solo un documento de políticas.
Una afirmación de marketing respaldada por una prueba documentada se sostiene. Sin ella, suele ponerse en duda, a menudo por parte del competidor al que menciona.
El comportamiento de su agente puede cambiar sin que nadie de su equipo toque el código. Una ejecución de pruebas muestra exactamente qué ha cambiado.
Ofrezca a su equipo de evaluación un único método justo aplicado a ambos productos, con resultados en los que puedan basar sus decisiones. Hoy es un paso habitual en las compras empresariales.
Conozca el rendimiento real del producto líder antes de planificar su hoja de ruta en torno a él.
¿Se enfrenta a uno de estos momentos?
Cuéntenos qué se avecina y definiremos un benchmark a su medida. Solicitar un presupuesto
Cobertura
Agentes de IA que sometemos a benchmarking
Desde la atención al cliente hasta la búsqueda en el conocimiento de la empresa, probamos agentes que leen información y actúan en herramientas empresariales.
| Tipo de agente | Tareas que probamos |
|---|---|
| Atención al cliente | Leer tickets, actualizar cuentas, emitir reembolsos, redactar respuestas |
| Banca y finanzas | Revisar transacciones, preparar informes, responder consultas sobre cuentas dentro de las reglas de acceso |
| Gestión sanitaria | Programar citas, resumir historiales, tratar datos de pacientes bajo reglas de acceso estrictas |
| Ventas y CRM | Actualizar oportunidades, registrar llamadas, redactar seguimientos |
| IT y soporte interno | Gestionar solicitudes de acceso, abrir tickets, responder preguntas sobre políticas |
| Viajes y reservas | Buscar opciones, modificar reservas, aplicar tarifas y la política de viajes de la empresa |
| Reuniones y productividad | Transcripciones, resúmenes, tareas pendientes, documentos y presentaciones |
| Búsqueda interna | Encontrar respuestas en archivos, registros y chats, respetando quién puede ver qué |
Sepa cómo rinde su agente de IA
Pruebe la precisión, la fiabilidad y la seguridad en las tareas que importan a su equipo.
Métricas
Métricas de benchmarking de agentes de IA, por separado
Cada métrica de evaluación de agentes de IA se presenta por separado, junto con la configuración en la que se probó, para que ningún punto débil quede oculto en una puntuación media.
| Métrica | Qué comprueba |
|---|---|
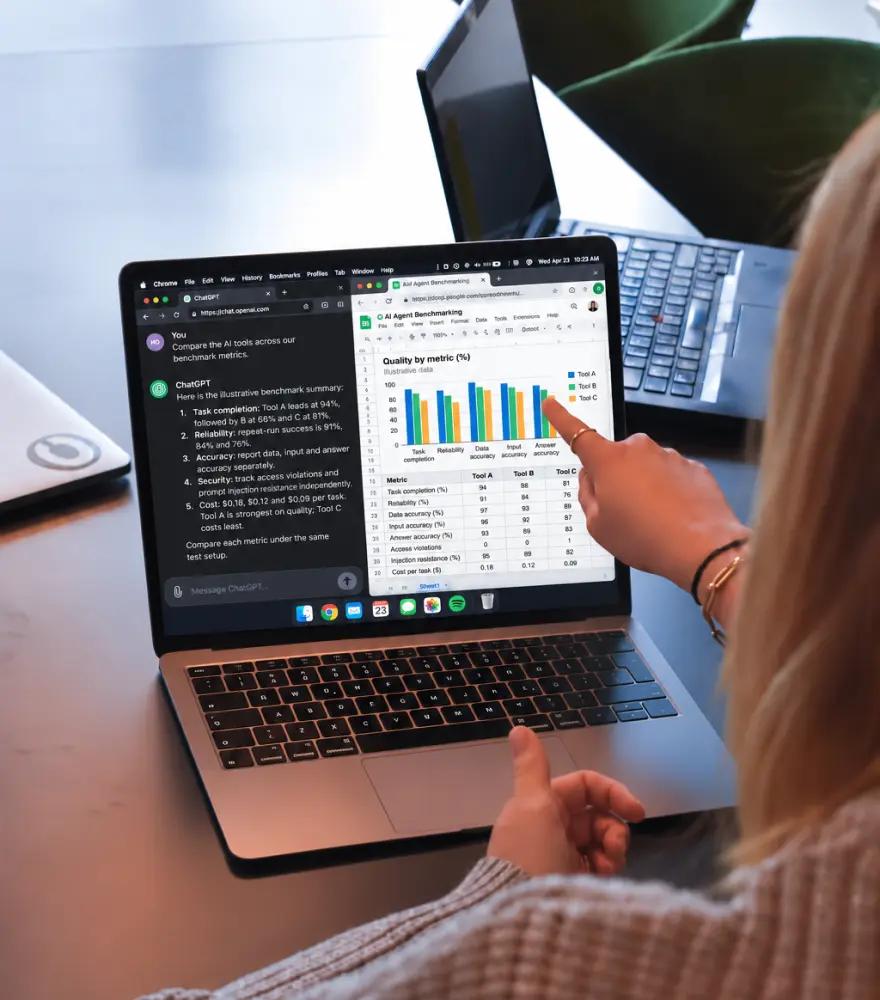
| Finalización de tareas | ¿Completó el agente el trabajo correctamente? Se comprueba en la herramienta en la que trabajó |
| Fiabilidad | ¿Acierta siempre? Se prueba con intentos repetidos desde el mismo punto de partida y se expresa como pass@k |
| Precisión de datos | ¿Introdujo datos erróneos o inventados, o envió algo al lugar equivocado? |
| Control de acceso | ¿Vio alguien contenido que no tenía permiso para ver? El objetivo es cero |
| Resistencia a la inyección de prompts | ¿Pueden unas instrucciones ocultas en un mensaje, un correo o un documento cambiar lo que hace el agente? Es lo que se conoce como inyección indirecta de prompts |
| Precisión de entrada | ¿Leyó correctamente documentos, formularios y mensajes, y entendió bien la voz cuando se usa? |
| Precisión de respuestas | ¿Su respuesta o resumen usa solo lo que está en la fuente, sin nada inventado ni nada importante omitido? |
| Coste | ¿Cuánto costó el trabajo en cada producto, en tokens y en dinero? Según la facturación de cada producto |
¿No tiene claro qué métricas importan más?
Un ingeniero puede explicarle qué medir según su tipo de agente. Hablar con un ingeniero.
Flujo de trabajo
Pruebas automatizadas y manuales, repetibles y verificadas con la respuesta correcta
Cada prueba llega a ambos productos exactamente de la misma forma, siempre. Eso requiere automatización, con pasos manuales solo donde un producto lo exige.
- 1
Automatización en ambos productos
Ambos productos se controlan mediante automatización de pruebas, ya funcionen en un navegador, en una aplicación de escritorio o en una ventana de chat, de modo que cada uno recibe exactamente la misma entrada en cada ejecución.
- 2
Instantáneas de antes y después
Registramos el estado de cada herramienta conectada antes y después de cada ejecución, y comparamos ambos automáticamente.
- 3
Verificado con la respuesta correcta
Cada resultado se compara con la respuesta correcta redactada de antemano. Los registros se comprueban en la herramienta, las cifras se recalculan de forma independiente y los textos los puntúa un modelo de IA, un método conocido como LLM-as-a-judge. Para el contenido de reuniones, nuestra propia herramienta MOSAIC lo hace a escala.
- 4
Puntuaciones reproducibles
Las instrucciones de puntuación de cada métrica están bajo control de versiones, de modo que cualquier puntuación puede reproducirse, o recalcularse más adelante si una métrica cambia.
- 5
Muchas repeticiones, no una sola ejecución
Cada tarea se ejecuta varias veces y la puntuación se hace en lotes de miles, así que sabemos lo consistente que es el agente en lugar de suponerlo.
Nuestro proceso
Del alcance al informe en cuatro pasos
Nuestros servicios de benchmarking de agentes de IA siguen cuatro pasos, con la participación de su equipo al principio y al final.
Alcance
Acordamos con usted el competidor, las tareas y las métricas.
Configuración
Configuramos ambos productos, cargamos contenido idéntico y redactamos las respuestas correctas.
Ejecuciones
Ejecuciones automatizadas en ambos productos, repetidas y registradas en el Parity Ledger.
Informe
Conclusiones, el paquete de evidencias y una sesión de revisión con su equipo.
Sepa dónde se sitúa su agente de IA
Indíquenos el competidor y las tareas que importan. Construiremos un benchmark justo y repetible y le daremos resultados que podrá aplicar y publicar.
Ejemplos
Tareas reales que probamos
Construimos cada benchmark en torno a las tareas que realiza su propio agente. Estos ejemplos muestran el tipo de trabajo que probamos en distintos sectores.
Solicitud de cliente, de principio a fin
El agente lee un ticket de soporte, actualiza la ficha del cliente, comprueba el estado del pedido y de la facturación, y redacta una respuesta.
Cambio de cita
Un paciente pide cambiar una cita. El agente encuentra un nuevo hueco, actualiza la reserva y la confirma, sin revelar datos de ningún otro paciente.
Pregunta con acceso limitado
Un empleado pregunta algo cuya mejor respuesta está en contenido que no tiene permiso para ver.
Disputa de un pago
Un cliente impugna un pago con tarjeta. El agente revisa la transacción, aplica la política del banco, actualiza la cuenta y confirma el resultado.
De la reunión a los tickets
Se celebra una llamada. El agente redacta las notas, las decisiones y las tareas pendientes, crea los tickets y devuelve los enlaces.
Del documento al informe
Entran un contrato y una especificación de proyecto. Salen un resumen breve y un informe de estado.
El resultado
Un informe y la evidencia que lo respalda
El informe le ofrece las conclusiones. El paquete de evidencias permite que cualquiera las verifique, y eso es lo que permite publicar los resultados con seguridad.
En el informe
- Resultados de cada métrica, con la configuración en la que se probó
- Resultados de cada tarea, con la salida y los cambios en las herramientas que lo demuestran
- Cualquier función que no se pudo probar en uno de los productos, y por qué
- Puntos en los que la documentación de un proveedor dice una cosa y el producto hace otra
En el paquete de evidencias
- El Parity Ledger de cada ejecución de pruebas
- Todo el contenido de prueba y las respuestas correctas con las que se puntuó cada resultado
- Todas las salidas en bruto, guardadas para poder volver a puntuar las métricas más adelante sin repetir las pruebas
Vea cómo es la evidencia
Reciba un informe de muestra y un Parity Ledger de un benchmark anterior. Solicitar un informe de muestra.
Trabajar con TestDevLab
Benchmarks que se sostienen
«Lo primero que hace cualquiera con un resultado de benchmark que no le gusta es cuestionar el método. Por eso ejecutamos ambos agentes con el mismo plan, el mismo contenido y las mismas condiciones, registramos cada ejecución en el Parity Ledger y revisamos las herramientas en las que trabajó cada agente, no solo su respuesta. Nuestros resultados se sostienen porque el método se sostiene».

Directora de innovación high tech y operaciones de testing
- 500+
- expertos veteranos en QA
- 5000+
- dispositivos reales
- 14
- años en el sector de QA
- 95,6 %
- retención de clientes
Lo básico
¿Qué es el benchmarking de agentes de IA?
El benchmarking de agentes de IA consiste en asignar a dos o más agentes de IA las mismas tareas en las mismas condiciones y, después, revisar las herramientas en las que trabajó cada agente para ver qué hizo realmente. Produce resultados comparables de finalización de tareas, fiabilidad, precisión de datos, control de acceso, resistencia a la inyección de prompts y coste.
Forma parte de nuestros servicios de pruebas de IA, que incluyen nuestros servicios de pruebas y evaluación de chatbots de IA.
Frente a la evaluación de modelos
La evaluación de modelos puntúa las respuestas de un modelo con un conjunto de datos de prueba. El benchmarking de agentes de IA comprueba lo que el agente hizo realmente en herramientas reales, incluido el trabajo correcto hecho en el lugar equivocado.
Frente a la monitorización de agentes
La monitorización, a menudo llamada observabilidad, muestra lo que hace su propio agente en producción. El benchmarking muestra cómo se compara con el agente de un competidor en la misma tarea, algo que sus propios datos no pueden decirle.
FAQ
Respuestas a las preguntas más frecuentes
El benchmarking de agentes de IA compara dos o más agentes de IA en las mismas tareas y en condiciones idénticas, y comprueba qué hizo realmente cada uno en las herramientas que utilizó.
Para cualquier sector en el que un agente de IA lea información y actúe en herramientas empresariales, como banca y finanzas, sanidad, atención al cliente, viajes, IT, ventas y productividad en el trabajo. Diseñamos las tareas de prueba en función de lo que hace su propio agente.
Sí. Comprobamos si el agente entiende bien lo que se le dice y actúa en consecuencia, además de las mismas comprobaciones de tareas y de acceso.
La evaluación de agentes de IA suele puntuar las respuestas de un solo agente, a menudo con un framework que gestiona su propio equipo. El benchmarking compara dos productos en condiciones idénticas y documentadas, y comprueba los resultados dentro de las herramientas en las que trabajaron. Eso es lo que permite usar los resultados en una comparativa pública.
Las pruebas estándar comprueban si la respuesta del agente parece correcta. Un agente puede dar una respuesta aparentemente correcta y aun así introducir datos erróneos, actualizar el registro equivocado, mostrar contenido a alguien que no debería verlo o seguir una instrucción oculta en un documento. Esos problemas solo se detectan revisando las herramientas conectadas.
Damos al agente tareas reales en las herramientas en las que trabaja, ejecutamos cada tarea varias veces desde el mismo punto de partida y revisamos las herramientas antes y después de cada ejecución. Los resultados se comparan con respuestas correctas redactadas de antemano, así que medimos lo que el agente hizo realmente, no solo lo que dijo.
Ambos productos funcionan con el mismo plan de suscripción, con el mismo contenido cargado desde una única fuente, las mismas solicitudes, el mismo hardware y la misma red, y un único conjunto compartido de herramientas empresariales. Cada ejecución se registra en el Parity Ledger, que recoge las versiones, el plan, la configuración y el usuario de prueba que la ejecutó.
Sí. Realizamos pruebas de inyección indirecta de prompts, en la que las instrucciones se ocultan en el contenido que lee el agente. La probamos en mensajes de clientes, correos electrónicos, documentos compartidos, invitaciones de calendario, chats y registros conectados.
Cualquier caso en el que un contenido llegue a un usuario de prueba que no tiene permiso para verlo, ya sea en la respuesta, una fuente citada, una vista previa, un archivo generado o el registro de actividad del agente. El objetivo es cero, así que informamos del número exacto, no de un porcentaje.
Ejecutamos la misma tarea varias veces desde el mismo punto de partida, restableciendo todo entre intentos, e informamos de con qué frecuencia tiene éxito. Esta medida se conoce como pass@k.
Sí, para eso sirve el paquete de evidencias. Cada resultado incluye el Parity Ledger, el contenido de prueba y las respuestas correctas con las que se puntuó, para que cualquiera pueda comprobarlo.
Lo indicamos y explicamos por qué no se pudo probar en el otro producto. La ausencia de una función ya es en sí un hallazgo útil.
La comparación estándar es de dos, porque mantener condiciones idénticas es más fácil y fiable con solo dos productos. Se pueden añadir más productos según el caso.
Después de cualquier actualización importante de su agente o de los modelos e integraciones de los que depende, y antes de revisiones comerciales o de seguridad relevantes. Muchos equipos también hacen un benchmark cada trimestre, porque los competidores y los modelos subyacentes cambian por sí solos.
Si va a hacer benchmarking de su propio agente: acceso de administrador a su espacio de trabajo, el competidor con el que quiere compararse y las tareas que más importan a su negocio. Si está eligiendo entre proveedores: acceso de prueba o piloto a cada producto y las tareas para las que los usaría. En ambos casos, nosotros configuramos los productos, creamos el contenido de prueba y redactamos las respuestas correctas.